




根據國際權威數據研究機構IDC的預測,全球數據創建量在2030 年將達到約590 ZB。在這個數據呈指數級爆炸的時代,大數據分析(Big Data Analytics)已成為企業在激烈市場競爭中突圍、實現精準經營的核心能力。大數據不只是技術工具的導入,更是一套將原始資料轉化為商業洞察,並落實至企業決策的完整流程。
一、大數據分析與應用的核心概念
大數據分析與應用是一個將龐雜、無序的資料轉化為有價值資訊的系統性工程。其核心在於理解資料的物理特性、明確分析的商業目的,以及建立數據驅動決策(Data-Driven Decision Making, DDDM)的閉環流程。
1. 大數據定義(5V特性)
大數據通常是指規模巨大、生成速度極快,且無法在可接受的時間內使用傳統資料庫工具進行擷取、儲存、管理和處理的資料集。大數據的的核心特徵可以用 5V特性 來概括:
- 資料量(Volume):資料規模極其龐大,從 TB(Terabyte)、PB(Petabyte)甚至達到 EB(Exabyte)級別。
- 處理速度(Velocity):資料的產生與傳輸速度極快(如 IoT 感測器數據、金融交易流),需要實時(Real-time)或近實時的處理與反應。
- 資料多樣性(Variety):涵蓋結構化資料(如 SQL 資料庫)、半結構化資料(如 XML, JSON, 系統日誌)與非結構化資料(如社群媒體貼文、圖像、影片、語音)。
- 資料真實性(Veracity):指資料的品質、可信度與準確性。巨量資料中常伴隨大量噪聲(Noise)與缺失值,需經過嚴格的清洗與驗證。
- 商業價值(Value):這是大數據應用的終極目標。如何在低價值密度的海量數據中,提煉出高價值的商業決策依據,是大數據的核心價值所在。
2. 大數據分析是什麼
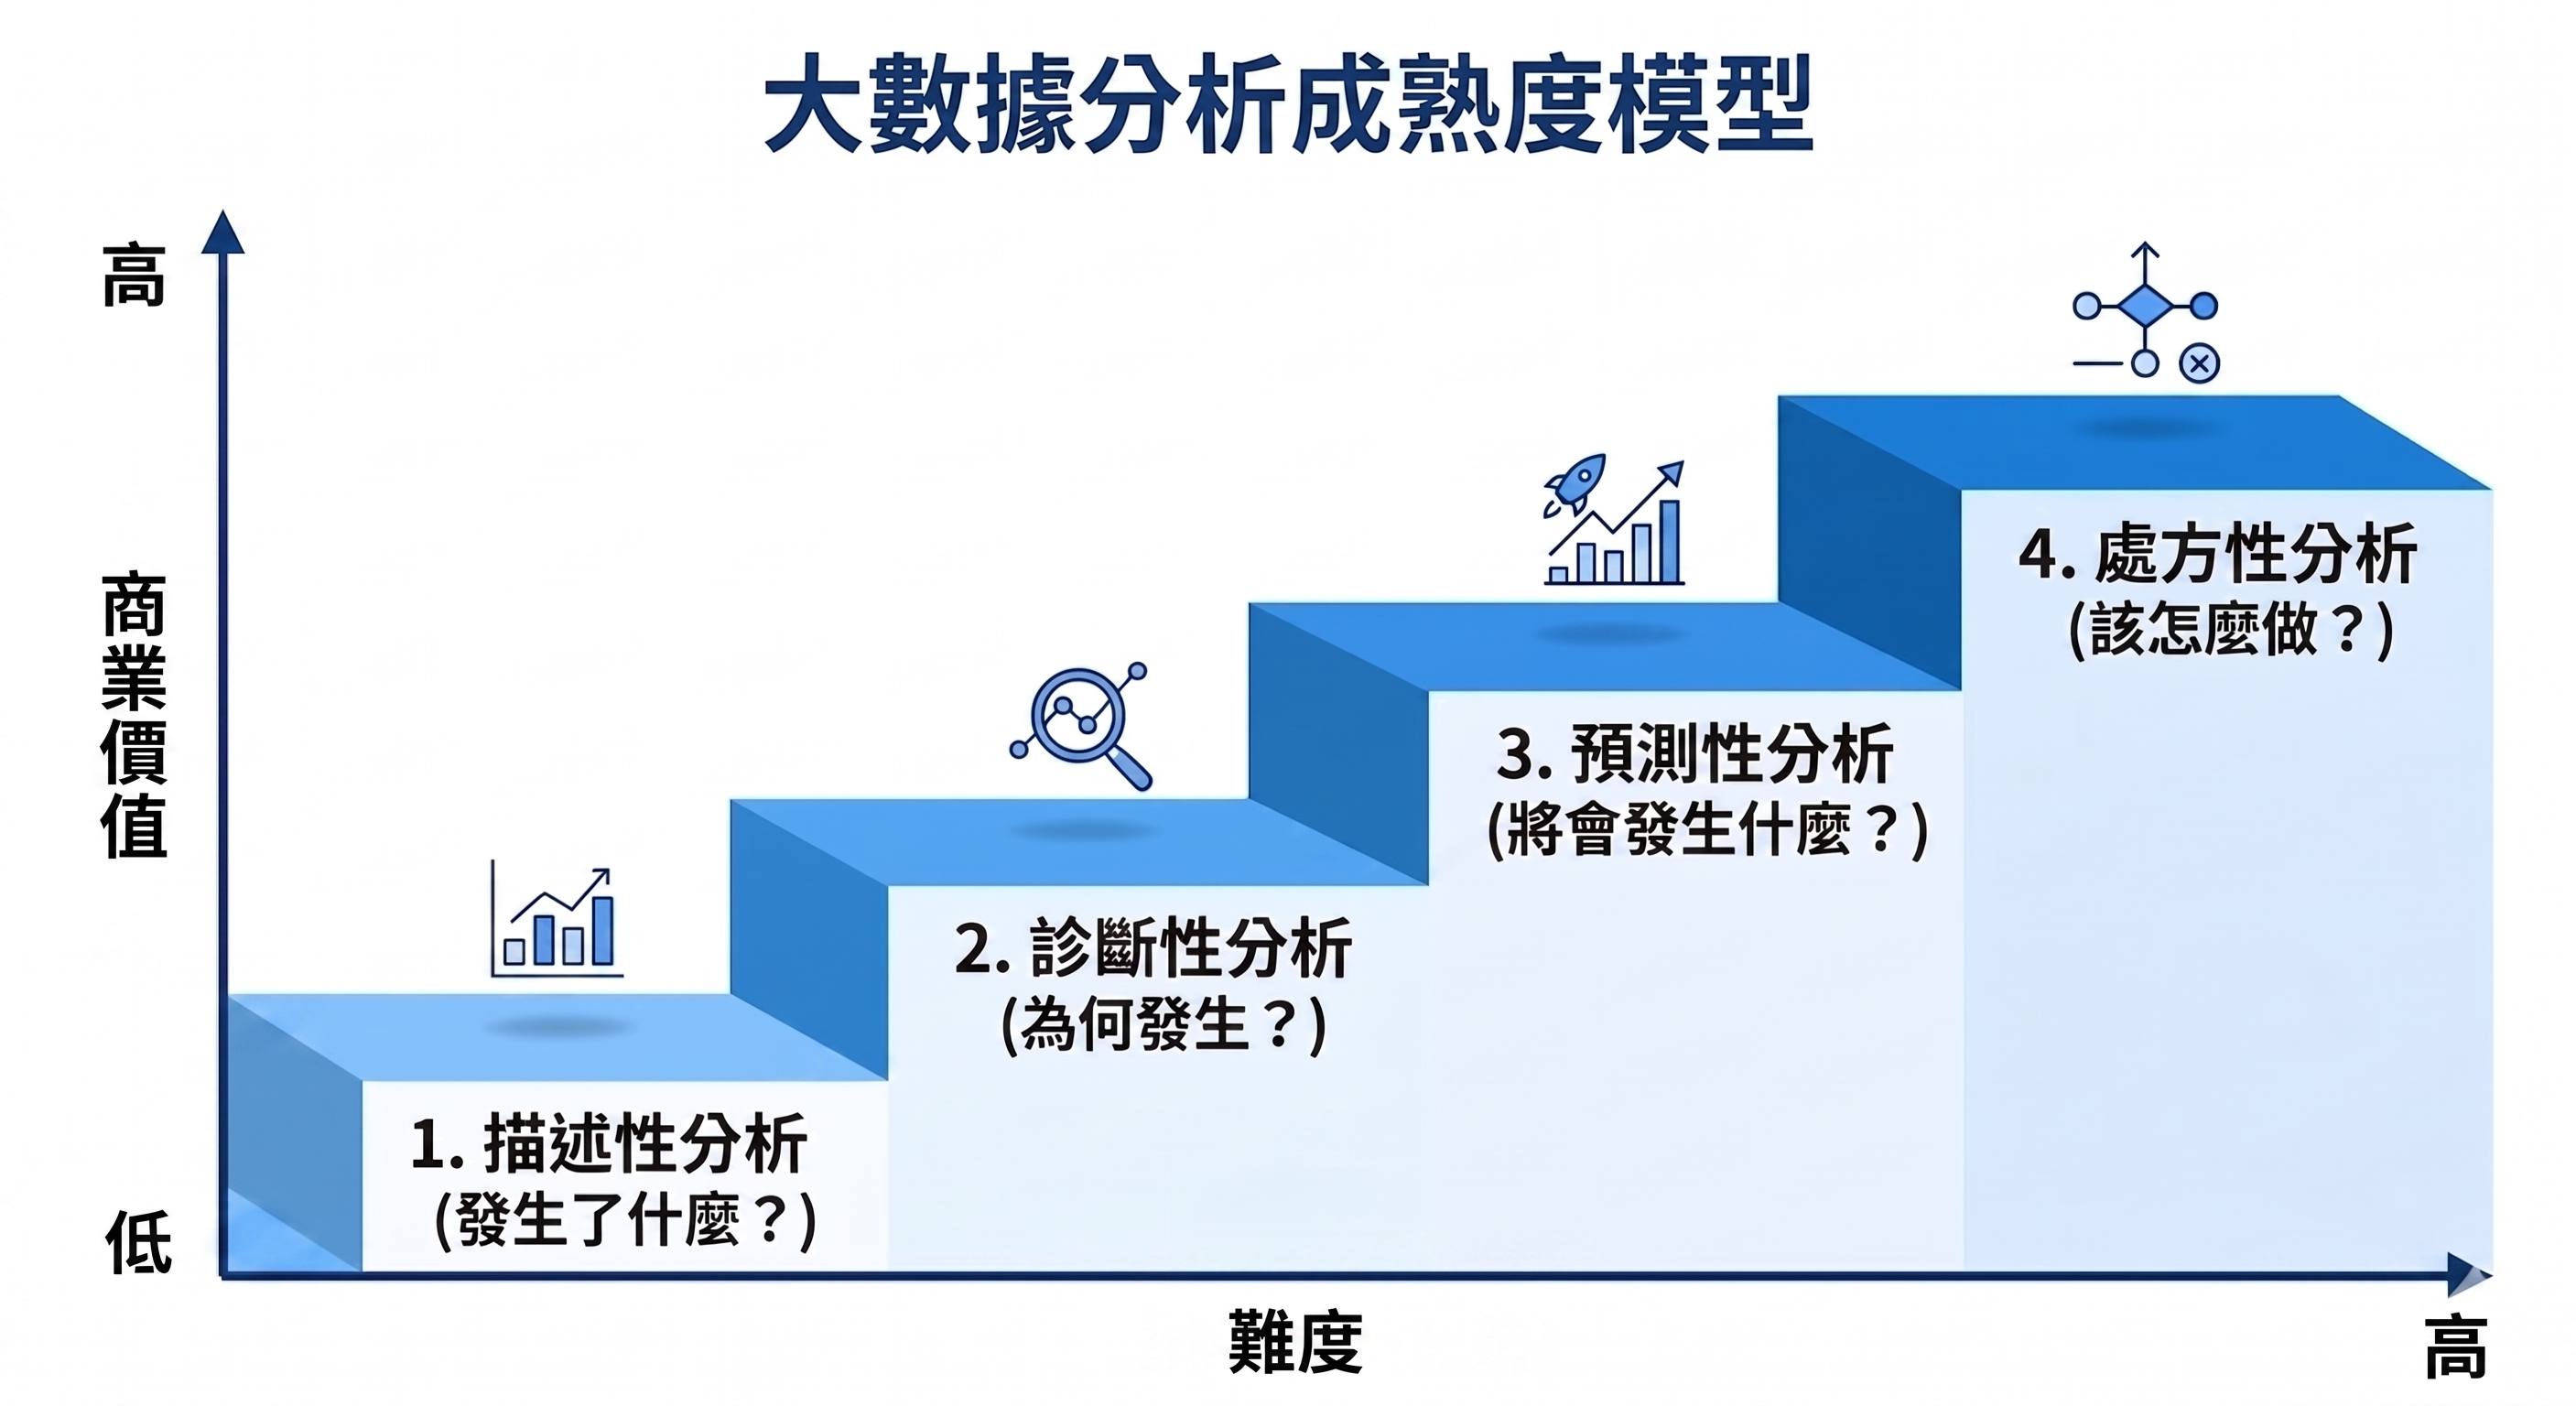
大數據分析是利用統計學、機器學習、資料探勘及分散式運算技術,從巨量資料中發掘隱含模式、未知關聯性與商業趨勢的過程。根據 Gartner 的定義,大數據分析依深度可分為四個層次:
- 描述性分析(Descriptive Analytics):「發生了什麼?」透過歷史數據的匯總與視覺化(例如月度銷售報表),呈現企業過去的營運現況。
- 診斷性分析(Diagnostic Analytics):「為什麼會發生?」利用交叉分析、維度下鑽(Drill-down)與資料探勘,找出營運指標變動的根本原因(例如分析特定地區業績下滑的主因)。
- 預測性分析(Predictive Analytics):「未來可能發生什麼?」建構統計與機器學習模型(如迴歸、時間序列分析),預測未來的市場趨勢或客戶行為(例如預測下季的產品需求量)。
- 決策性分析(Prescriptive Analytics):「我們該怎麼做?」結合最佳化演算法與模擬技術,直接為企業決策者提供具體的行動建議與優化路徑(例如自動規劃出成本最低的物流配送路線)。
3. 大數據應用是什麼
大數據應用是將分析產出的洞察,無縫整合進企業的商業流程中並轉化為實質行動的階段。一個完整的大數據應用專案通常包含以下閉環:從業務部門提出具體的「商業問題」出發,經歷資料收集、清理前處理、模型建立與評估,再將模型結果透過互動式視覺化儀表板或 API 串接至業務系統中。最終,決策者依據這些數據洞察調整營運策略(如動態定價、精準行銷、智慧排程),並持續收集反饋數據以進行模型迭代。
4. 企業為什麼需要大數據分析
在高度不確定的市場環境中,企業若僅依賴高層管理者的「傳統經驗決策」(靠直覺、過往經驗),將面臨巨大的認知偏誤與決策風險。
導入大數據分析能促使企業轉向「數據驅動決策 (DDDM)」:
- 提升營運效率:透過實時監控與資源最佳化,降低不必要的營運成本。
- 發掘潛在商機:精準描繪客戶畫像,預測消費者潛在需求,開發個性化商品。
- 強化風險管理:在金融貸前審查、製造業設備維護等場景,及早預警潛在風險,減少資產損失。
二、大數據例子:生活場景與日常應用
大數據並非遙不可及的冷冰冰技術,它早已融入我們每天的數位生活體驗中,背後仰賴的是複雜的資料流處理與機器學習演算法。
1. 搜尋引擎推薦
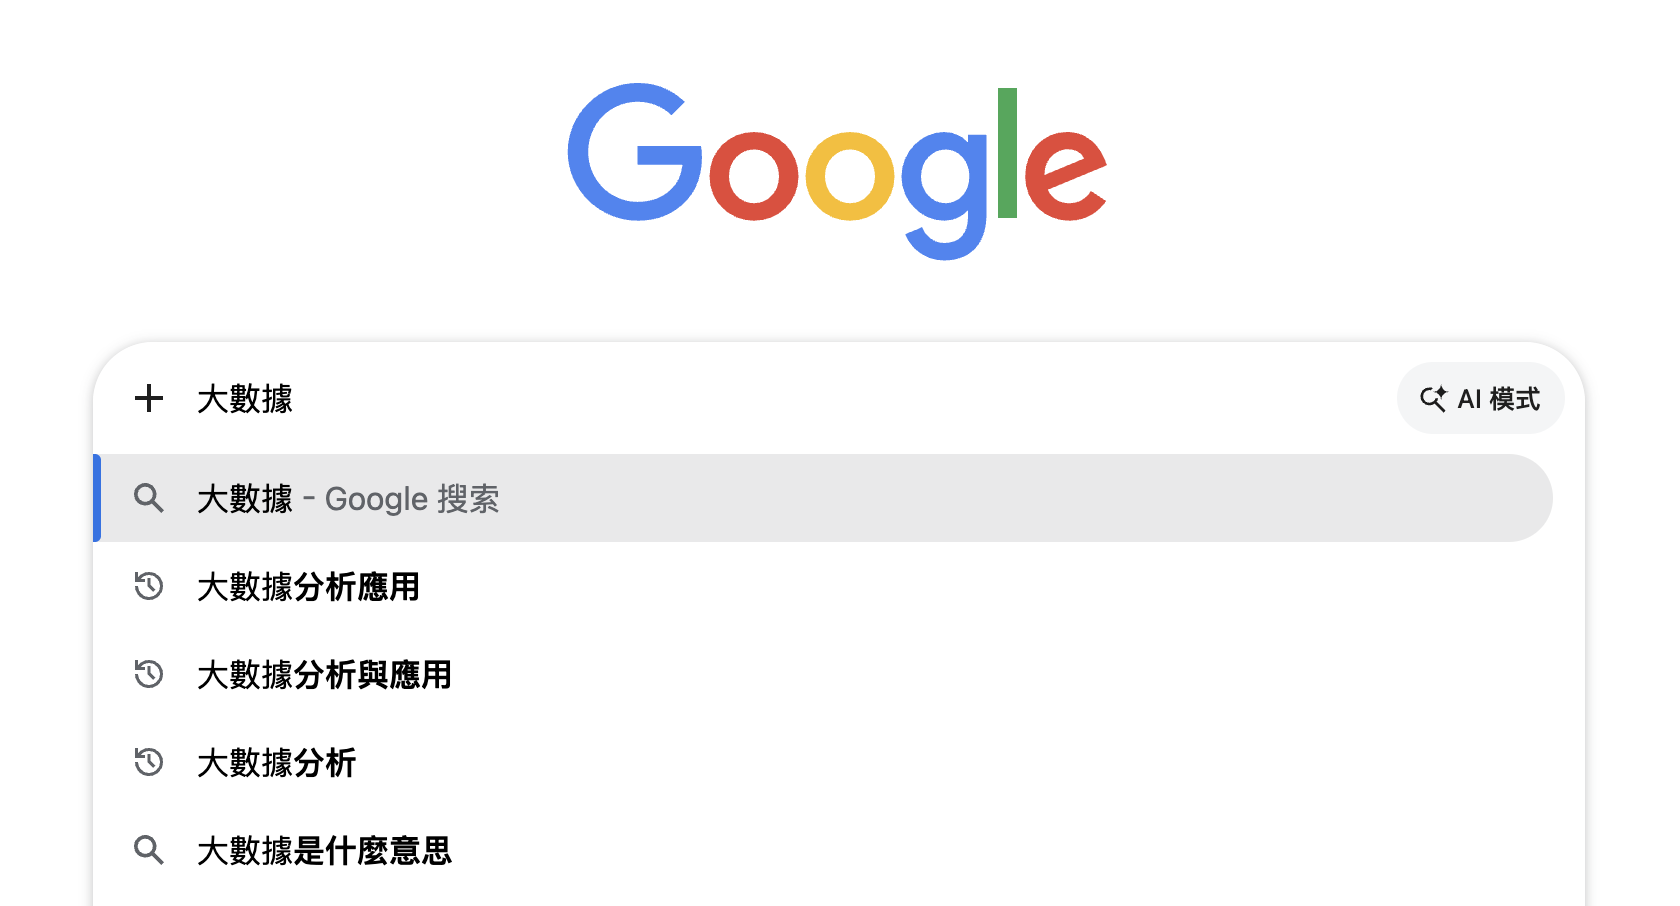
當你在 Google 輸入關鍵字時,搜尋結果的排序與自動補全(Autocomplete)便是大數據應用的經典展現。系統會在毫秒內分析你的歷史搜尋紀錄、當下地理位置、設備類型,並結合全球數十億用戶的實時點擊趨勢,利用 PageRank 及深度學習模型,從數百億個網頁中計算出最符合你當下意圖的搜尋結果。
2. 影音推薦系統
YouTube 或 Netflix 的個人化推薦機制,是藉由分析用戶的觀看歷史、停留時間、快轉行為、評分紀錄,並與其他數億名擁有相似觀影特徵的用戶進行比對。背後運用了協同過濾(Collaborative Filtering)與基於內容的過濾演算法,即時推估你下一秒最可能點擊的影片,顯著提升了平台的黏著度與用戶體驗。
3. 社群平台內容分發
Instagram Reels 或 TikTok 的「為你推薦」演算法是行為大數據分析的極致應用。系統透過追蹤用戶在每支短影音的觀看完整度(完播率)、重複觀看次數、點讚、評論及分享行為,將用戶特徵與影片標籤(如音樂、題材、創作者)進行高維度矩陣匹配,實現千人千面的個性化內容精準推送。
4. 電商推薦系統
在蝦皮購物(Shopee)上常看到的「購買此商品的客戶也購買了...」或個人化商品推薦牆,是典型的關聯規則(Association Rules)與矩陣分解(Matrix Factorization)技術應用。系統分析數百萬筆交易訂單,挖掘商品與商品之間的隱性關聯(如經典的「啤酒與尿布」),從而實現高效的交叉銷售(Cross-selling)與向上銷售(Up-selling)。
5. 智慧導航與即時路況
Google Maps 能精準預估到達時間並規劃最佳避堵路線,是因為它每分每秒都在接收並處理全球數億台智慧型手機的匿名 GPS 定位與移動速度數據。系統將這些實時流式數據與歷史交通模式、當前天氣、道路施工事件進行即時整合分析,運用圖論(Graph Theory)與路徑最佳化演算法,動態為每位駕駛規劃最省時的導航路徑。
三、大數據分析與應用的實作流程
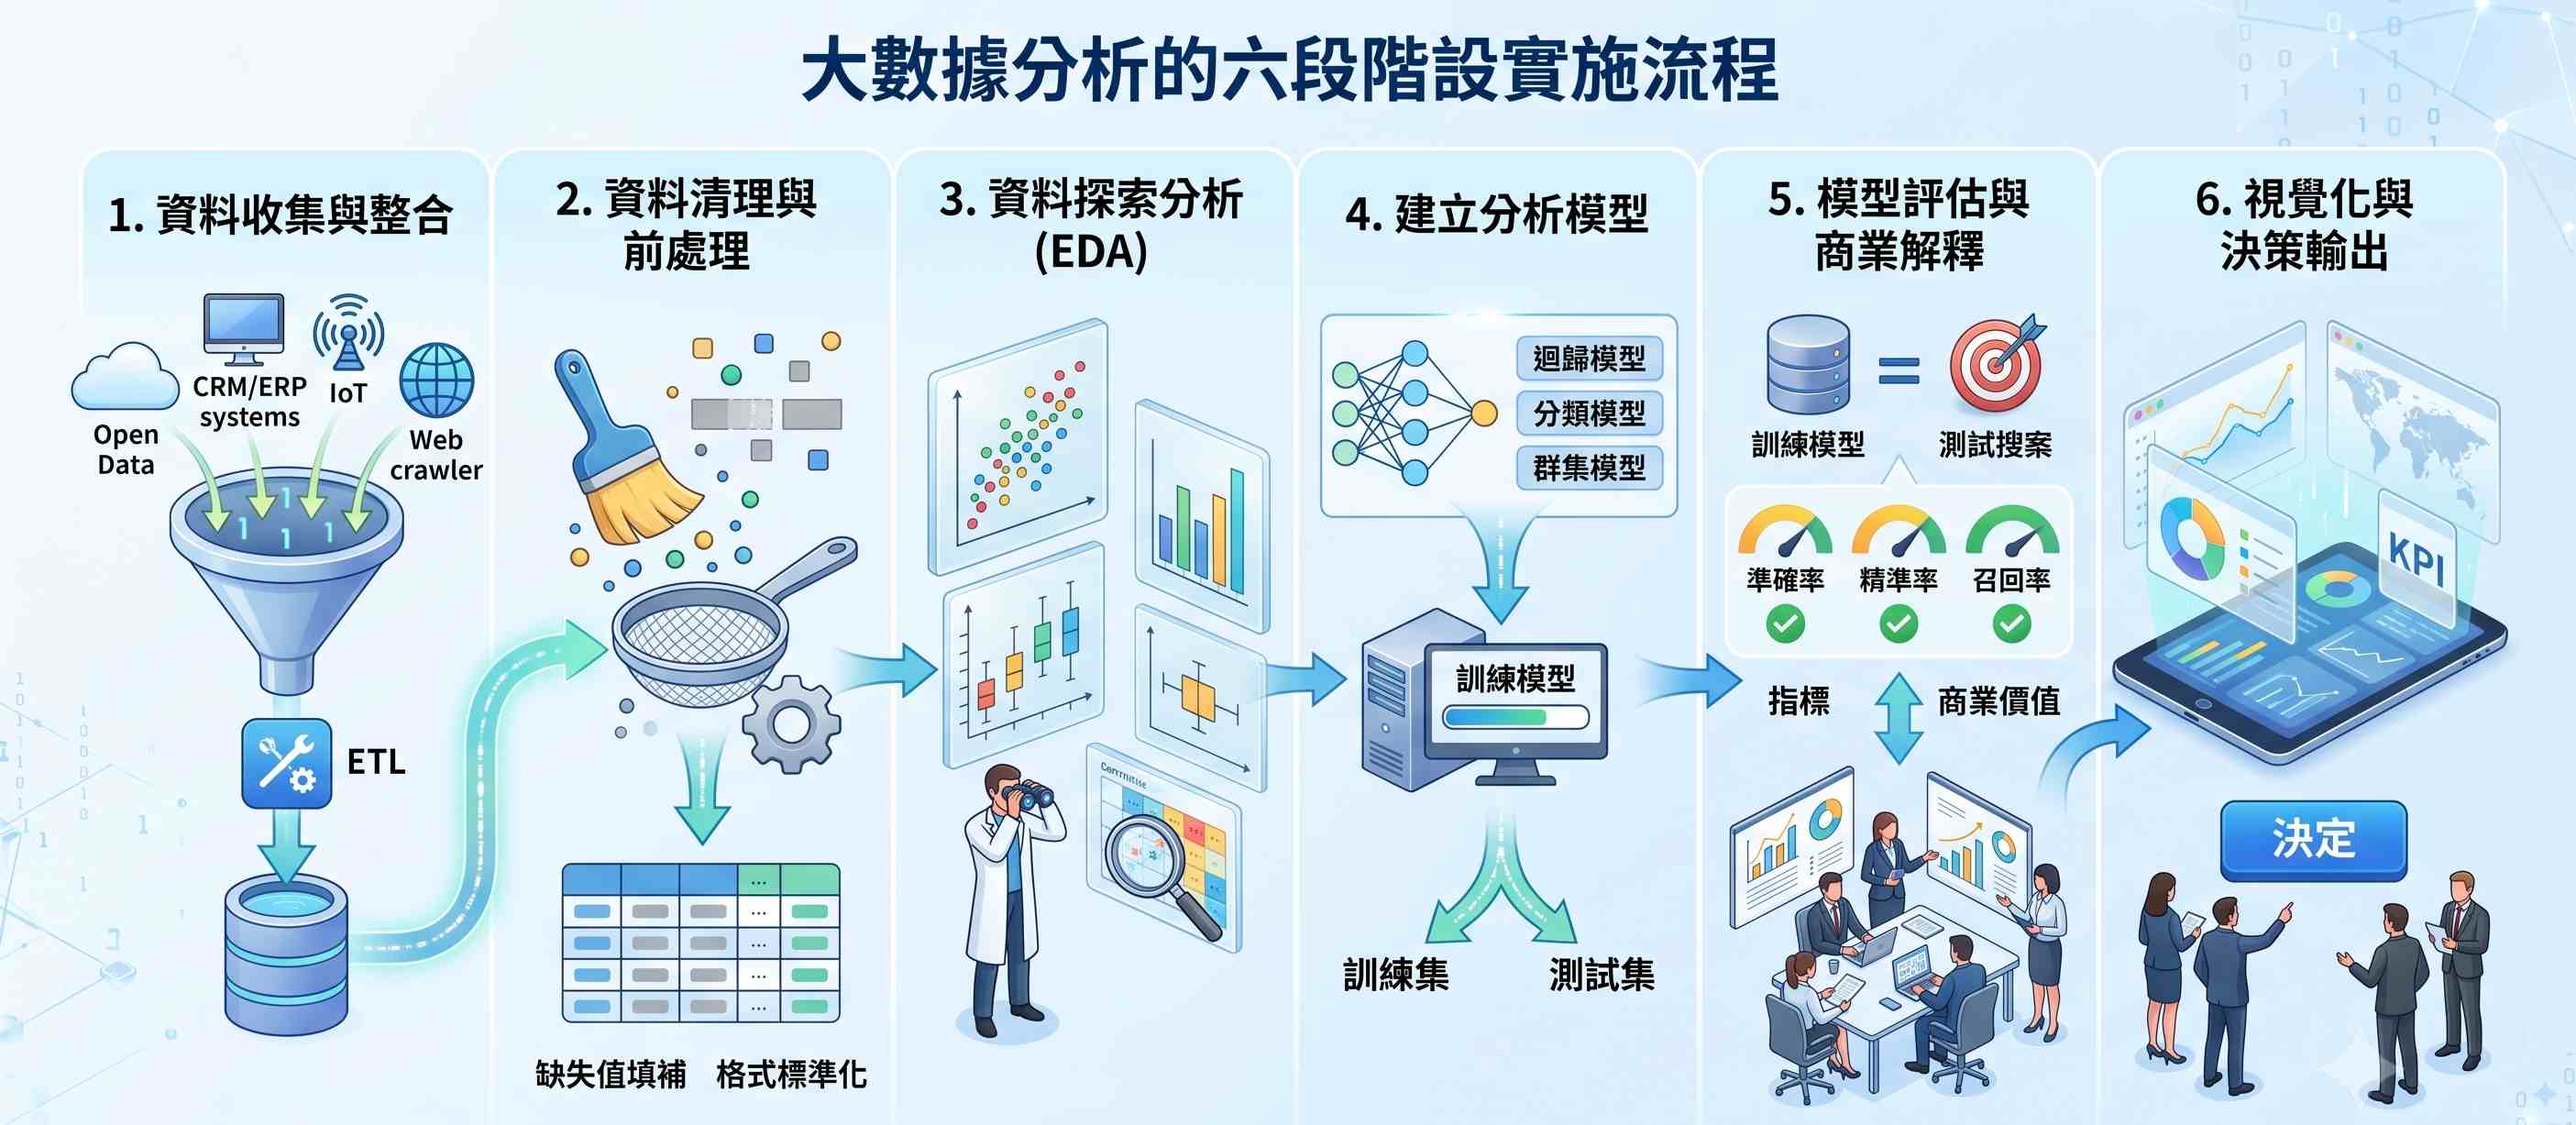
一套成功的大數據分析專案,必須遵循嚴謹且標準化的工程流程,才能確保資料從原始狀態一步步提煉成可信的商業價值,實現資料驅動決策。
1. 資料收集與整合
實作的第一步是從多元管道擷取原始資料。這些資料來源包括內部關聯式資料庫(如 CRM、ERP 系統)、IoT 感測器傳回的時間序列數據,以及外部網頁爬蟲、社群媒體平台或公開的政府開放數據(Open Data)。此階段的技術核心在於使用 ETL(Extract, Transform, Load)工具,將這些格式各異的數據整合至統一的資料湖(Data Lake)或資料倉儲(Data Warehouse)中。
2. 資料清理與前處理
收集到的原始資料往往是「髒資料」,包含大量缺失值(Missing Values)、重複紀錄、格式不一致、或極端的異常值(Outliers)。此步驟需利用資料科學工具進行數據清洗:例如使用統計均值或插值法填補缺失值、利用標準分數(Z-score)剔除異常值、將時間格式統一標準化,並進行資料型態轉換(如將類別特徵進行 One-Hot 編碼),為後續建模奠定高品質的資料基石。
3. 資料探索分析(EDA)
在建立正式預測模型前,資料科學家會進行探索性資料分析(Exploratory Data Analysis, EDA)。透過計算描述性統計量(如均值、中位數、標準差)並繪製資料分布圖(如直方圖、箱形圖、散佈圖),來觀察特徵之間的相關性、識別潛在的模式,並藉此檢驗研究假設,為特徵工程(Feature Engineering)提供方向。
4. 建立分析模型
根據商業目標選擇合適的統計或機器學習演算法。若是預測連續數值(如銷量、房價),採用迴歸模型(Regression);若是預測分類標籤(如客戶流失、信用卡欺詐),採用分類模型(Classification);若是在無標籤狀態下進行客戶畫像區隔,則採用群集模型(Clustering)。此階段會將資料切分為訓練集與測試集,並使用交叉驗證(Cross-Validation)來優化模型參數。
5. 模型評估與商業解釋
模型訓練完成後,必須在未參與訓練的測試集上進行評估。分類模型常用準確率(Accuracy)、精準率(Precision)、召回率(Recall)與 F1-Score 進行評估;迴歸模型則常用均方誤差(MSE)或R2決定係數。更關鍵的是,必須將這些抽象的數學指標轉譯成商務語境下的 KPI,並解釋模型的決策邊界,以獲得業務團隊的信任。
6. 視覺化與決策輸出
最後,將分析模型輸出的預測結果與洞察,透過儀表板(如 FineBI)進行可視化呈現。設計良好的視覺化報表能讓企業決策者一目了然地掌握關鍵指標趨勢與潛在預警,進而將數據洞察轉化為具體的商業決策與行動。
四、大數據分析應用案例
大數據的商業價值並非憑空而來,以下透過帆軟在製造業與零售業的真實客戶轉型案例,深入探討大數據分析在企業實際場景中的落地應用。
1. 製造業的大數據分析應用
案例一:全球傳動(打破資料孤島與資料探勘排程優化)
- 面臨痛點:作為深耕 40 年的傳動元件大廠,全球傳動過去累積的海量生產與訂單資料,長期散落在 SAP(財務)、MES(生產)、WMS(倉儲)與 SCM(供應鏈)等四大異質系統中。這種數據孤島使得跨系統報表極為耗時,決策層無法即時掌握工廠脈動與客製化訂單的真實成本。
- 解決方案:從數位化基礎建設(PDA 報工與 IoT 機聯網)出發,推進至智慧製造經營模式,系統即時整合投入產出與成本,並透過資料探勘(Data Mining)與多維度交叉分析,精準抓出高營收卻低毛利的「負擔型訂單」,進一步利用演算法模擬最佳的生產排程,達成生產資源的最佳化配置。
- 實際成效:客製化訂單的平均交貨天數由 57.8 天大幅縮短至 30.3 天(縮短近 50%)。符合客戶需求的訂單達交率從 95% 提升至 98%,並帶動客戶滿意度指標從 81.1 攀升至 85.6,實現了達交率與滿意度的雙雙提升。
案例二:燁輝企業(大數據異常偵測與行動化戰情室)
- 面臨痛點:在高度複雜的鋼鐵產線上,舊有報表工具無法負荷需求,一份報表往往需要開發三套程式,修改極耗人力。此外,部門間缺乏透明度,難以即時預警工安或生產的潛在異常。
- 解決方案:以「紅黃綠管理法」設計智慧戰情看板,涵蓋工安衛室的高空動火預告、機電點檢等。更重要的是,透過設定大數據異常偵測(Anomaly Detection)邏輯,當機電設備的即時數據偏離常態分佈時主動觸發警報,並將看板整合至 LINE 平台,從被動的報表監控升級為實時的風險預測防護網。
- 實際成效:報表開發時間大幅縮短 87%(從 15 小時降低至 2 小時)。透過將警衛管制表單數位化(每日處理約 200 輛車),每年成功為企業節省超過 2,000 小時工時,有效突破人力瓶頸。
2. 零售與電商業的大數據分析應用
案例三:富邦媒體 momo(機器學習分群賦能與決策極速化)
- 面臨痛點:在極速變化的電商戰場中,傳統高度依賴 IT 的「週報月報模式」嚴重滯後。全公司 54 個單位有多達 800 份口徑不一的報表,分析需求大排長龍,產生巨大溝通損耗。
- 解決方案:底層技術移轉至 StarRocks 引擎並導入 K8s 容器化管理,確保千萬級數據「秒級返回」。同時將 FineBI 與 CDP 無縫串接,透過 OneID 統一客戶視角,並結合機器學習的分群演算法(如 K-Means)與 RFM 顧客價值模型,從千萬級的瀏覽日誌中精準識別出高價值與潛在流失客群,將大數據預測結果直接賦能給一線行銷團隊。
- 實際成效:成功跨 54 個單位統一口徑超過 800 份報表。決策週期徹底進化為「看指標就能動」,並透過自動對接與自助探索,成功解放了高達 83% 的人工彙整與撈單工時。
案例四:一之軒(地端數據中樞與購物籃關聯分析)
- 面臨痛點:為因應多角化經營,一之軒陸續引進了會員、票券、電子標價卡與 AI 影像辨識等多套異質系統。仰賴外部廠商客製化串接 API 不僅耗資龐大,更面臨營運資料與商業創新機密流失的隱憂。
- 解決方案:導入 FineDataLink(FDL)作為企業專屬的地端數據中樞,資訊團隊在內部防火牆內安全地自主整合 ERP、POS 及各項外部系統。擁有乾淨的底層資料後,營運團隊得以利用大數據進行購物籃關聯分析(Market Basket Analysis),找出烘焙商品與飲品的最佳搭售組合,從而在各直營門市落實數據驅動的精準行銷策略。
- 實際成效:IT 團隊在短短 4 個月內,便自主完成了 5 個核心 API 系統的串接,穩健支援全台 30 家直營門市的營運。透過與 HR 系統連動,更實現了員工進出自動開通與關閉專屬會員帳號,省下可觀的客製化開發費用。
五、大數據分析與應用的技術架構與常用工具
大數據分析的落實,必須建立在穩定、可擴展的軟硬體架構及豐富的工具生態系之上。以下剖析主流的大數據技術棧。
1. 大數據系統整體架構
一個標準的現代企業大數據系統,在技術上通常劃分為三層架構:
graph TD
    subgraph 資料來源層
        A[交易數據 RDBMS] --> D[資料收集工具]
        B[系統日誌 JSON/Logs] --> D
        C[IoT感測器/行爲流] --> D
    end

    subgraph 資料處理與儲存層
        D[Kafka / Flume / ETL] --> E[資料湖 Hadoop HDFS / S3]
        D --> F[資料倉儲 BigQuery / Snowflake]
        E --> G[計算引擎 Spark / MapReduce]
        F --> G
    end

    subgraph 資料應用與視覺化層
        G --> H[機器學習/預測模型]
        G --> I[BI 工具 FineReport / FineBI]
        G --> J[AI Agent 自然語言問數]
    end
- 資料儲存與收集層:負責數據的擷取與沉澱。資料湖(Data Lake)用於儲存未經加工的原始非結構化數據,資料倉儲(Data Warehouse)則儲存經過清洗、建模的結構化業務指標。
- 計算與處理層:大數據的核心引擎。負責大規模數據的並行運算、轉換與機器學習特徵提取。
- 視覺化與應用層:將底層運算結果輸出,與 BI 工具、機器學習模型或 AI 智慧助手(如 Dora)進行對接,轉化為用戶可讀的報表與決策依據。
2. 資料來源類型
大數據的輸入源主要可歸納為三類:
- 交易數據(Transactional Data):如訂單、支付紀錄、庫存變動。這類數據結構清晰,通常儲存在關聯式資料庫中,對資料一致性(ACID 特性)要求高。
- 物聯網數據(IoT Time-Series Data):來自廠區感測器、車載 GPS、智慧穿戴設備的時序數據。特點是高頻率、大流量,但單筆數據價值密度低。
- 用戶行為數據(Behavioral Data):如網站點擊流(Clickstream)、APP 瀏覽路徑、社群媒體互動。這類數據多為半結構化或非結構化,是進行用戶畫像與推薦系統的關鍵原料。
3. 資料儲存架構
因應數據特性不同,儲存架構已從單一資料庫演進為混合儲存架構:
- 資料倉儲(Data Warehouse):如 MPP(大規模並行處理)架構的 Greenplum,或雲端託管的 BigQuery、Snowflake。採用列式儲存(Columnar Storage),極大優化了大規模 OLAP 聚合查詢效能。
- 資料湖(Data Lake):如 Apache Hadoop HDFS、Amazon S3。能以最原始的格式儲存結構化、半結構化及非結構化數據,成本低廉,為資料科學家提供最原汁原味的數據資源。
- 湖倉一體(Lakehouse):近年新興趨勢(如 Apache Iceberg、Delta Lake),在資料湖的廉價儲存之上,引入了 ACID 交易支持、資料版本控制(Time Travel)與結構化管理,兼具兩者優勢。
4. 數據處理模式
- 批次處理(Batch Processing):將一段時間內累積的數據打包,進行一次性的離線計算。特點是處理數據量極大、延遲較高(數十分鐘至數小時),常用於產生財務月報、日銷量總結等。代表技術為 Hadoop MapReduce、Apache Spark。
- 流式處理(Stream Processing):對源源不斷產生的數據流進行即時、低延遲的逐筆計算。特點是時效性極高(毫秒至秒級),適用於信用卡異常交易即時攔截、實時廣告競價、即時路況更新等。代表技術為 Apache Flink、Spark Streaming。
5. 分散式運算基礎
當資料量達到 PB 級別時,單機運算已無法負荷,必須依賴分散式運算框架。
Hadoop(分散式儲存與批次運算基石)
- HDFS(Hadoop Distributed File System): 採用主從(Master/Slave)架構。一個 NameNode 作為 Master 管理檔案系統的元數據(Metadata)與目錄樹,多個 DataNode 作為 Slave 實際儲存數據塊(Block)。HDFS 預設會將每個數據塊複製三份(副本機制),分散儲存在不同節點上,提供極高的容錯性與資料可靠性。
- MapReduce: 一種分散式編程模型。其核心機制是將計算任務拆分為兩個階段:Map(映射)將大任務分解為多個子任務分發到數據所在的節點上執行(體現「數據就近運算,避免網路傳輸」的原則);Reduce(規約)則將各節點的計算結果進行匯總與合併。
Spark(記憶體內運算新星)
- 記憶體運算(In-Memory Computing): 相較於 MapReduce 在每個 Map 與 Reduce 步驟之間都必須將中間結果寫入硬碟(產生大量 I/O 瓶頸),Spark 盡可能將所有計算的中間數據緩存在記憶體中,這使得其反覆迭代的運算速度比 Hadoop 快上 10 到 100 倍。
- RDD(Resilient Distributed Dataset): 彈性分布式資料集,是 Spark 的核心抽象。RDD 是唯讀且分區的,它支援惰性求值(Lazy Evaluation)——只有當觸發 Action 算子時,Spark 才會真正執行計算。同時,RDD 記錄了其產生過程的血緣(Lineage),一旦某個分區數據遺失,Spark 可以根據血緣關係自動在記憶體中重新計算,確保了極高的容錯性。
- 豐富的生態子系統: Spark SQL 允許使用標準 SQL 查詢結構化數據;Spark MLlib 提供了分布式機器學習演算法庫;Spark Structured Streaming 則能實現高吞吐量的即時數據處理。
延伸閱讀: 大數據資料庫推薦
6. 工具生態概覽
核心統計機器學習演算法解析
在大數據分析中,機器學習演算法是提煉預測能力的關鍵。以下解析三種最常用的經典演算法(已依改稿指南精簡為核心名詞解析)。
1. 線性迴歸(Linear Regression)
這是一種預測「連續型數值」的監督式學習演算法。它藉由找出自變數(影響因素)與應變數(預測目標)之間的線性關係(類似一條最佳擬合直線),來推估未來的數值變動。
應用場景:預測銷量、房價或營收。例如,根據歷史廣告投放預算來預估下一季的產品銷售額。
2. K-Means 群集分析(K-Means Clustering)
這是一種將資料「自動分類」的非監督式學習演算法。它不需預先標註標籤,而是透過計算資料點之間的相似度(距離),將特徵相近的資料歸為同一群集,反覆迭代直到分類收斂。
應用場景:客群細分。例如,根據顧客的購買頻率與消費金額,自動將客戶區分為「高價值客戶」、「潛力客戶」與「低活躍客戶」。
3. 決策樹(Decision Tree)
這是一種用來「分類或預測」的監督式學習演算法。它模擬人類做決策的邏輯,透過一連串的「二分法」問題(如「年齡是否大於 30?」),將資料集逐步劃分成更純粹的小群體,最終形成樹狀的決策規則。
應用場景:預測客戶流失、信用評估。例如,分析電信客戶的特徵,預估其是否會退租。
Python 大數據分析與機器學習實作範例
以下展示一個極簡的 Python 實作範例(使用真實的公開「紅酒品質資料集」),示範從資料匯入、清理到建立基礎決策樹模型的核心步驟:
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeClassifier
from sklearn.metrics import accuracy_score

# 1. 匯入公開紅酒品質資料集 (UCI Machine Learning Repository)
url = "https://archive.ics.uci.edu/ml/machine-learning-databases/wine-quality/winequality-red.csv"
df = pd.read_csv(url, sep=';')

# 2. 資料清理與前處理:移除缺失值,將品質分數轉為二分類標籤 (分數 >= 6 為優良(1),其餘為普通(0))
df = df.dropna()
df['good_quality'] = (df['quality'] >= 6).astype(int)

# 3. 劃分特徵與標籤,並切分訓練集與測試集 (80% 訓練, 20% 測試)
X = df.drop(columns=['quality', 'good_quality'])
y = df['good_quality']
X_train, X_test, y_train, y_test = train_test_split(
    X, y, test_size=0.2, random_state=42
)

# 4. 建立並訓練決策樹模型 (限制最大深度以防過擬合)
model = DecisionTreeClassifier(max_depth=3, random_state=42)
model.fit(X_train, y_train)

# 5. 評估模型準確度
predictions = model.predict(X_test)
print(f"模型預測準確度: {accuracy_score(y_test, predictions):.2%}")
六、大數據產業趨勢與未來發展
大數據技術並非一成不變,隨著計算能力的提升與業務場景的演進,以下四大趨勢正深刻重塑企業的數據生態。
1. AI + 大數據融合
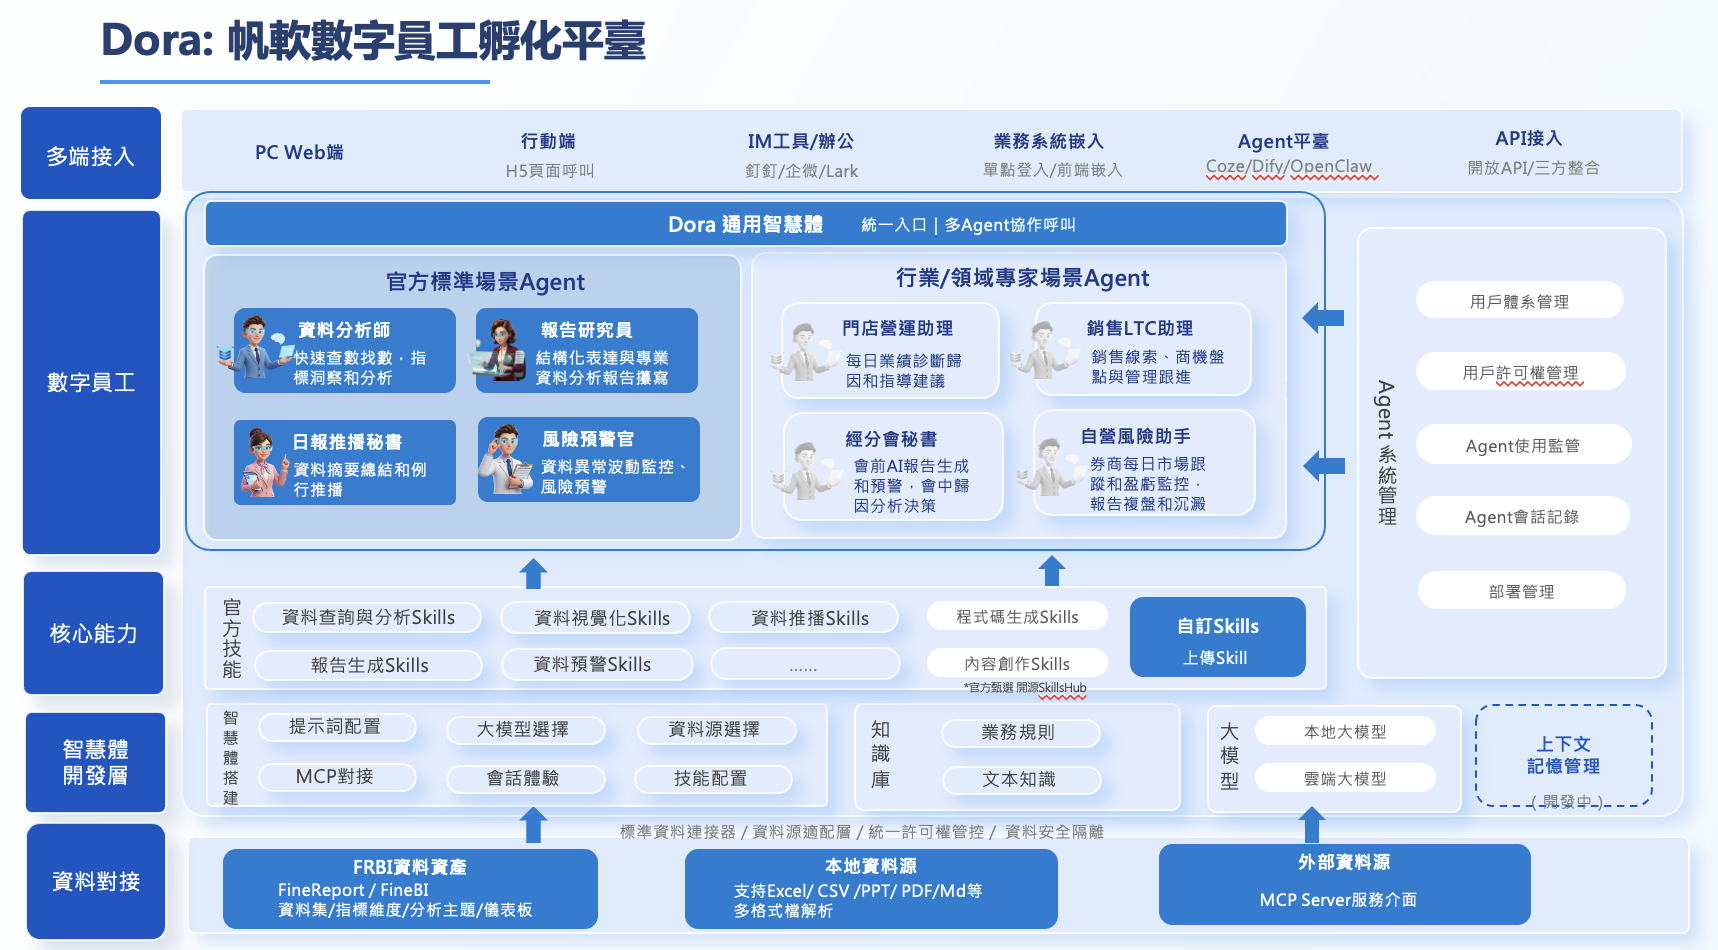
人工智慧與大數據的結合正從簡單的預測模型,演進為智慧分析助手(如 Dora)。Dora 是帆軟新推出的一款智慧分析助手,依託人工智慧技術,可快速封裝、配置適應不同業務場景的資料智慧體,讓企業有了多位不同職能、準確執行資料任務的「數位員工」。它能連接企業既有 BI、報表、資料平台與權限體系。業務人員不再需要撰寫複雜的 SQL 語法或手動拉取 BI 報表,只需透過自然語言與 Dora 對話,Dora 便能運用專業的資料分析 Skill,自動執行查數、歸因分析、圖表生成、報告產出、定時推送與異常預警等流程,實現從發現問題到解決問題的完整閉環,大幅降低企業數據的使用門檻。
2. 即時數據分析
隨著 Apache Flink 等實時流處理技術的普及,企業對數據分析時效性的要求已從「日報/週報」演進為「秒級響應」。即時分析能在電商促銷活動中動態監控轉化漏斗、即時調整廣告出價,或在製造業產線上實時捕獲品質異常,創造即時的業務價值。
3. 數據中台與企業數據治理
企業在累積了海量數據後,往往會面臨口徑不一致、資料重覆計算等混亂局面。因此,建構數據中台以統一資料標準、管理資料血緣關係(Data Lineage),並落實涵蓋數據權限控管、隱私安全合規與數據品質監控的 資料治理(Data Governance) 體系,已成為數據驅動型企業的數位基礎建設。
4. IoT 與智慧製造整合
工業物聯網(IIoT)設備產生的大規模時間序列數據,與大數據分析緊密結合。工廠能夠透過產線數據的即時融合,實現排程最佳化、能源消耗精細化管理以及供應鏈端到端的可視化,成為推動製造業數位轉型的核心引擎。
七、大數據技術挑戰與限制
雖然大數據帶來了巨大的商業價值,但企業在實際導入與落地過程中,往往需要克服以下硬性技術挑戰:
1. 資料品質問題(Garbage in, Garbage out)
「垃圾進,垃圾出」是大數據分析中不變的鐵律。若資料源存在大量缺失值、採樣偏差(Selection Bias)或系統噪聲,依此訓練出的機器學習模型將會產生嚴重的偏差,甚至導致管理層做出錯誤決策。因此,建立完善的自動化資料清洗與品質監控管道是分析專案中最耗時但也最關鍵的任務。
2. 資料孤島與系統整合困難
企業內部的資料往往分散在財務、銷售、供應鏈等不同部門各自為政的異質系統中。打破這些「資料孤島」不僅需要解決複雜的接口調用與異構數據轉換等技術難題,更涉及組織架構的跨部門協作與利益重新分配。
3. 模型過擬合與泛化能力問題
在建模過程中,模型可能在歷史訓練數據上表現得非常完美,但在面對真實世界的全新數據時,預測效果卻一落千丈,此即為過擬合(Overfitting)。確保模型具備良好的泛化能力(Generalization Ability),需要資料科學家進行嚴格的交叉驗證、引入正則化(Regularization)限制模型複雜度,並在生產環境中建立持續的模型監控與漂移(Drift)檢測機制。
4. 計算成本與效能瓶頸
儲存與運算 PB 級數據需要龐大的伺服器叢集,這對企業的 IT 預算構成了極大挑戰。雖然雲端服務(如 AWS、GCP)提供了彈性擴展的解決方案,但如何合理規劃資源、優化 SQL 查詢語法、優化分散式運算資源配置以避免高昂的雲端帳單,是架構師必修的課題。
5. 即時分析系統建置複雜度
相較於離線的批次處理,即時分析系統需要維運極其複雜的技術鏈結(如 Kafka 訊息佇列、Flink 流處理引擎、即時時序資料庫)。如何確保系統在高吞吐量下的低延遲、高可用性(High Availability)以及「精確一次(Exactly-Once)」的數據處理語意,具有極高的技術難度。
FAQs
大數據分析是利用統計學、機器學習、資料探勘及分散式運算技術,從海量、高增速且多元的資料集中發掘潛在模式、未知關聯性與商業洞察的系統性過程,目的在於輔助企業做出更科學的數據驅動決策。
在日常生活中,大數據已經深度融入各種數位服務,例如搜尋引擎會根據使用者行為與點擊偏好即時調整搜尋結果排序,以提升內容的相關性;影音平台則會根據觀看紀錄與相似用戶的行為進行推薦,讓每個人看到的內容都不一樣。
在企業場景中,大數據主要用來提升效率與降低風險。例如製造業會透過物聯網設備收集生產線數據,用於預測設備可能發生的故障,並優化整體製程良率;金融業會結合交易數據與用戶行為模型來評估信用風險,同時即時偵測異常交易以防止詐欺。
Python 是目前最主流的資料科學語言之一,擁有成熟的生態系,可支援資料處理、機器學習、資料視覺化及大規模分散式運算。Pandas、NumPy、Scikit-learn、Matplotlib 及 PySpark 等工具,讓 Python 成為企業與資料科學家進行大數據分析的重要工具。
建議先建立數學與統計基礎,再學習 SQL 與 Python 等核心工具,接著理解 Hadoop、Spark 等分散式運算框架,並熟悉 FineReport 或 FineBI 等 BI 視覺化工具。最後可透過實作專案與考取 iPAS 巨量資料分析師或 Google Data Analytics 等認證,逐步累積實務能力。


免費資源下載