用数据分析剔除异常值的方法有:均值和标准差法、四分位数法、箱线图法、Z-Score法、LOF局部离群因子法。其中,均值和标准差法是常用且有效的一种方法。均值和标准差法通过计算数据集的均值和标准差来识别异常值。具体步骤包括计算数据的均值,计算每个数据点与均值的差值,计算差值的平方和,然后取平均值,得到方差,再开平方得到标准差。定义一个阈值(通常为2或3倍的标准差),如果某个数据点与均值的差距超过这个阈值,则认为它是异常值。这种方法简单易行,适用于大多数数据集。
一、均值和标准差法
均值和标准差法是基于数据的正态分布假设,通过计算数据的均值和标准差来识别异常值。具体步骤如下:
-
计算均值:首先,计算数据集的均值,即所有数据点的总和除以数据点的数量。均值是数据集的中心值,能够反映数据的集中趋势。
-
计算标准差:接下来,计算标准差。标准差是数据点与均值差值的平方和的平均值的平方根,表示数据的离散程度。标准差越大,数据的波动越大。
-
定义阈值:通常使用2倍或3倍的标准差作为阈值,来判断数据点是否为异常值。具体阈值可以根据具体情况调整。
-
识别异常值:将每个数据点与均值的差值绝对值与阈值进行比较,如果超过阈值,则认为该数据点是异常值。
这种方法简单易行,适用于数据呈正态分布的情况。然而,对于非正态分布的数据集,可能需要其他方法来识别异常值。
二、四分位数法
四分位数法通过计算数据的四分位数来识别异常值。具体步骤如下:
-
计算四分位数:计算数据集的第一个四分位数(Q1)和第三个四分位数(Q3)。Q1是将数据按升序排列后处于第25%位置的值,Q3是处于第75%位置的值。
-
计算四分位距:四分位距(IQR)是Q3与Q1的差值,表示数据的离散程度。
-
定义阈值:通常使用1.5倍的四分位距作为阈值,来判断数据点是否为异常值。具体阈值可以根据具体情况调整。
-
识别异常值:将每个数据点与Q1和Q3的差值绝对值与阈值进行比较,如果超过阈值,则认为该数据点是异常值。
四分位数法不依赖于数据的分布形状,适用于各种类型的数据集,尤其是具有长尾分布的数据。
三、箱线图法
箱线图法通过绘制箱线图来识别异常值。具体步骤如下:
-
绘制箱线图:箱线图由一个矩形框和两条延伸线组成。矩形框的底部是Q1,顶部是Q3,框内的线是中位数。
-
计算须线长度:须线的长度通常定义为1.5倍的四分位距。上须线从Q3延伸到Q3加1.5倍的四分位距,下须线从Q1延伸到Q1减1.5倍的四分位距。
-
识别异常值:在箱线图中,超出须线范围的数据点被认为是异常值。
箱线图法直观且易于理解,适用于各种类型的数据集,尤其是数据量较大的情况下。
四、Z-Score法
Z-Score法通过计算数据点的标准化值来识别异常值。具体步骤如下:
-
计算均值和标准差:首先,计算数据集的均值和标准差。
-
计算Z-Score:对于每个数据点,计算其Z-Score。Z-Score是数据点与均值的差值除以标准差,表示数据点与均值的偏离程度。
-
定义阈值:通常使用2或3作为Z-Score的阈值,来判断数据点是否为异常值。具体阈值可以根据具体情况调整。
-
识别异常值:将每个数据点的Z-Score与阈值进行比较,如果超过阈值,则认为该数据点是异常值。
Z-Score法适用于数据呈正态分布的情况,能够准确识别出偏离均值较大的异常值。
五、LOF局部离群因子法
LOF局部离群因子法通过计算数据点的局部密度差异来识别异常值。具体步骤如下:
-
计算数据点的密度:对于每个数据点,计算其k近邻点的密度。密度表示数据点在其邻域内的稠密程度。
-
计算局部离群因子:对于每个数据点,计算其局部离群因子(LOF)。LOF是数据点的密度与其邻域内数据点密度的比值,表示数据点与其邻域数据点的密度差异。
-
定义阈值:通常使用1作为LOF的阈值,来判断数据点是否为异常值。具体阈值可以根据具体情况调整。
-
识别异常值:将每个数据点的LOF与阈值进行比较,如果超过阈值,则认为该数据点是异常值。
LOF局部离群因子法适用于各种类型的数据集,尤其是数据分布不均匀的情况下,能够准确识别出局部密度差异较大的异常值。
六、FineBI工具的应用
FineBI是帆软旗下的一款数据分析工具,能够帮助用户轻松进行异常值剔除。FineBI提供了多种数据分析功能,包括数据预处理、数据可视化和数据挖掘等。用户可以通过FineBI的简单操作界面,快速识别和剔除数据中的异常值,提高数据分析的准确性和可靠性。FineBI官网: https://s.fanruan.com/f459r;
FineBI的优势在于其强大的数据处理能力和灵活的分析功能,适用于各种类型的数据集。通过FineBI,用户可以轻松实现数据的清洗、转换和分析,提升数据分析的效率和效果。
使用FineBI进行异常值剔除的步骤如下:
-
数据导入:将数据集导入FineBI,FineBI支持多种数据源,包括数据库、Excel文件和CSV文件等。
-
数据预处理:通过FineBI的数据预处理功能,进行数据的清洗和转换,包括缺失值填补、数据格式转换和数据合并等。
-
异常值识别:利用FineBI的数据分析功能,应用均值和标准差法、四分位数法、箱线图法、Z-Score法或LOF局部离群因子法等方法,识别数据中的异常值。
-
异常值剔除:将识别出的异常值从数据集中剔除,生成干净的数据集。
-
数据分析:利用FineBI的数据可视化和数据挖掘功能,对清洗后的数据集进行深入分析,发现数据中的潜在规律和趋势。
FineBI的灵活性和强大功能使其成为数据分析的得力助手,能够帮助用户高效地进行数据预处理和分析,提高数据分析的准确性和可靠性。
七、实际案例分析
为了更好地理解如何使用数据分析方法剔除异常值,我们通过一个实际案例进行演示。假设我们有一个包含销售数据的Excel文件,数据包括产品ID、销售日期、销售数量和销售金额等。
步骤一:数据导入
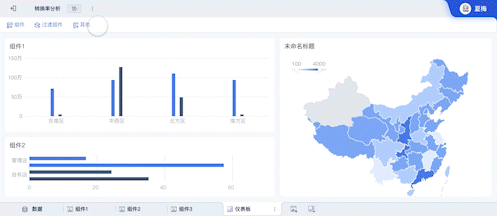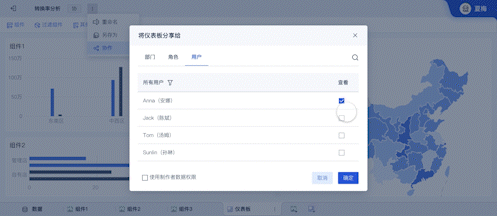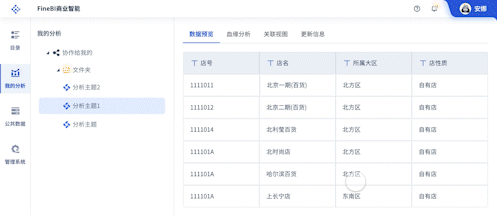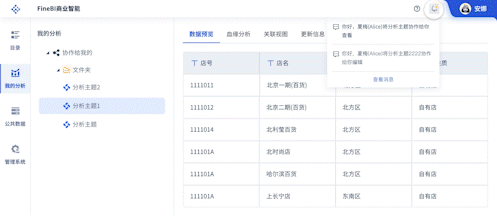
将Excel文件导入FineBI,FineBI会自动识别数据格式,并生成数据预览。
步骤二:数据预处理
在FineBI中,对数据进行预处理。首先,检查数据的完整性,填补缺失值。其次,对数据进行格式转换,将日期格式转换为标准日期格式。
步骤三:异常值识别
利用FineBI的数据分析功能,选择合适的异常值识别方法。假设我们选择均值和标准差法,首先计算销售数量和销售金额的均值和标准差,然后定义阈值(如2倍标准差),识别出异常值。
步骤四:异常值剔除
将识别出的异常值从数据集中剔除,生成干净的数据集。
步骤五:数据分析
利用FineBI的数据可视化功能,对清洗后的数据集进行分析。通过绘制销售趋势图、产品销量排名图等,发现数据中的潜在规律和趋势。
通过上述步骤,我们成功地利用数据分析方法剔除了异常值,提高了数据分析的准确性和可靠性。FineBI作为一款强大的数据分析工具,为数据预处理和分析提供了有力支持,帮助用户高效地进行数据分析工作。FineBI官网: https://s.fanruan.com/f459r;
八、总结与展望
数据分析中的异常值剔除是提高数据分析准确性的重要步骤。通过本文介绍的几种常用方法,包括均值和标准差法、四分位数法、箱线图法、Z-Score法、LOF局部离群因子法等,读者可以根据具体情况选择合适的方法进行异常值识别和剔除。
FineBI作为一款强大的数据分析工具,提供了丰富的数据预处理和分析功能,能够帮助用户高效地进行异常值剔除和数据分析。通过实际案例的演示,我们展示了如何利用FineBI进行数据预处理和分析,提高数据分析的准确性和可靠性。
在未来的数据分析工作中,我们可以结合更多的数据分析方法和工具,进一步提高数据分析的效率和效果,发现数据中的潜在规律和价值。FineBI官网: https://s.fanruan.com/f459r;
数据分析是一个不断发展的领域,随着技术的进步和数据量的增加,数据分析方法和工具也在不断创新和完善。我们应该保持学习和探索的态度,掌握最新的数据分析技术和工具,提高数据分析的能力和水平,为企业和社会创造更大的价值。
相关问答FAQs:
如何使用数据分析剔除异常值?
剔除异常值是数据分析中一个重要的环节,能够有效提升分析结果的准确性和可靠性。异常值通常指那些与数据集中的其他数据点显著不同的观测值,它们可能是数据错误、测量误差或真实的极端情况。下面将详细介绍几种常用的方法来识别和剔除异常值。
-
使用统计方法识别异常值
一种常见的方式是利用统计学方法来识别异常值。最常用的统计方法包括Z-score和IQR(四分位数间距)。Z-score方法通过计算每个数据点与均值的偏差程度来判断其是否为异常值。当Z-score的绝对值大于3时,通常被认为是异常值。IQR方法则是先计算数据的第一四分位数(Q1)和第三四分位数(Q3),然后计算IQR = Q3 – Q1。任何低于Q1 – 1.5 * IQR或高于Q3 + 1.5 * IQR的值通常被视为异常值。
-
数据可视化
数据可视化是识别异常值的直观方法。通过绘制箱线图、散点图或直方图,可以轻松识别出离群点。在箱线图中,箱体表示中间50%的数据分布,而箱体外的点则被视为潜在的异常值。散点图则可以展示两个变量之间的关系,若某些点偏离整体趋势明显,也可以被标记为异常值。通过这些可视化工具,数据分析师可以直观地识别出可能的异常值。
-
基于模型的异常值检测
另一种方法是使用机器学习模型来检测异常值。常见的模型包括孤立森林(Isolation Forest)和局部离群因子(Local Outlier Factor, LOF)。孤立森林通过构建随机树来“孤立”数据点,孤立程度高的点被认为是异常值。LOF则是通过比较每个点的局部密度与其邻近点的密度来判断异常值。此方法特别适用于高维数据,能够更精确地识别出复杂数据中的异常点。
异常值剔除后,如何验证数据的有效性?
在剔除异常值后,验证数据的有效性是至关重要的一步。有效性验证可以通过以下几种方法进行。
-
重新计算统计指标
剔除异常值后,务必重新计算均值、标准差、四分位数等统计指标。通过对比剔除前后的统计指标变化,可以了解异常值对整体数据分布的影响程度。如果剔除异常值后,数据的均值和标准差发生了明显变化,那么可以判断这些异常值确实对数据分析结果产生了较大影响。
-
交叉验证模型
在机器学习模型中,使用交叉验证来评估模型的性能是一个有效的策略。在剔除异常值后,可以使用交叉验证方法(例如K折交叉验证)来验证模型的泛化能力。如果模型在剔除异常值后表现更好,说明异常值确实对模型的训练产生了负面影响。
-
对比分析结果
进行剔除异常值前后的数据分析结果对比,可以帮助分析师直观地判断数据的有效性。通过对比剔除前后的可视化图表、趋势图、回归分析结果等,可以明确剔除异常值对最终分析结果的影响程度。
在实际数据分析中,如何处理异常值?
在数据分析的实践中,处理异常值的策略会因具体情况而异,以下是一些常用的方法。
-
直接剔除
对于一些明显的错误数据,可以选择直接剔除。这种方法简单易行,但需要确保剔除的数据确实是错误的,避免剔除掉真正的极端值。
-
替换法
在某些情况下,可以选择用均值、中位数或其他合理值来替换异常值。这种方法适用于数据集较小且异常值对整体分析影响不大的情况。替换法可以保留数据集的完整性,避免因数据缺失而产生的分析误差。
-
分组处理
对于一些异常值可以根据特定条件进行分组处理。例如,针对不同的子类数据,可以分别进行异常值检测和处理。这样的处理方式能更好地保持数据的真实特征,避免因整体剔除而导致的数据失真。
-
记录与标记
在剔除或替换异常值之前,最好将异常值记录下来,以备后续分析。这有助于在数据分析报告中提供透明性,并且可以为未来的研究提供参考依据。同时,标记异常值能够帮助分析师更好地理解数据的分布特征。
总结
剔除异常值是数据分析过程中的一项重要任务。通过多种统计方法、数据可视化和模型检测,分析师可以有效识别和处理异常值。剔除异常值后,通过重新计算统计指标、交叉验证和对比分析结果来验证数据的有效性同样不可忽视。根据具体情况选择合适的处理方法,能够帮助分析师提升数据分析的准确性和可靠性。
本文内容通过AI工具匹配关键字智能整合而成,仅供参考,帆软不对内容的真实、准确或完整作任何形式的承诺。具体产品功能请以帆软官方帮助文档为准,或联系您的对接销售进行咨询。如有其他问题,您可以通过联系blog@fanruan.com进行反馈,帆软收到您的反馈后将及时答复和处理。