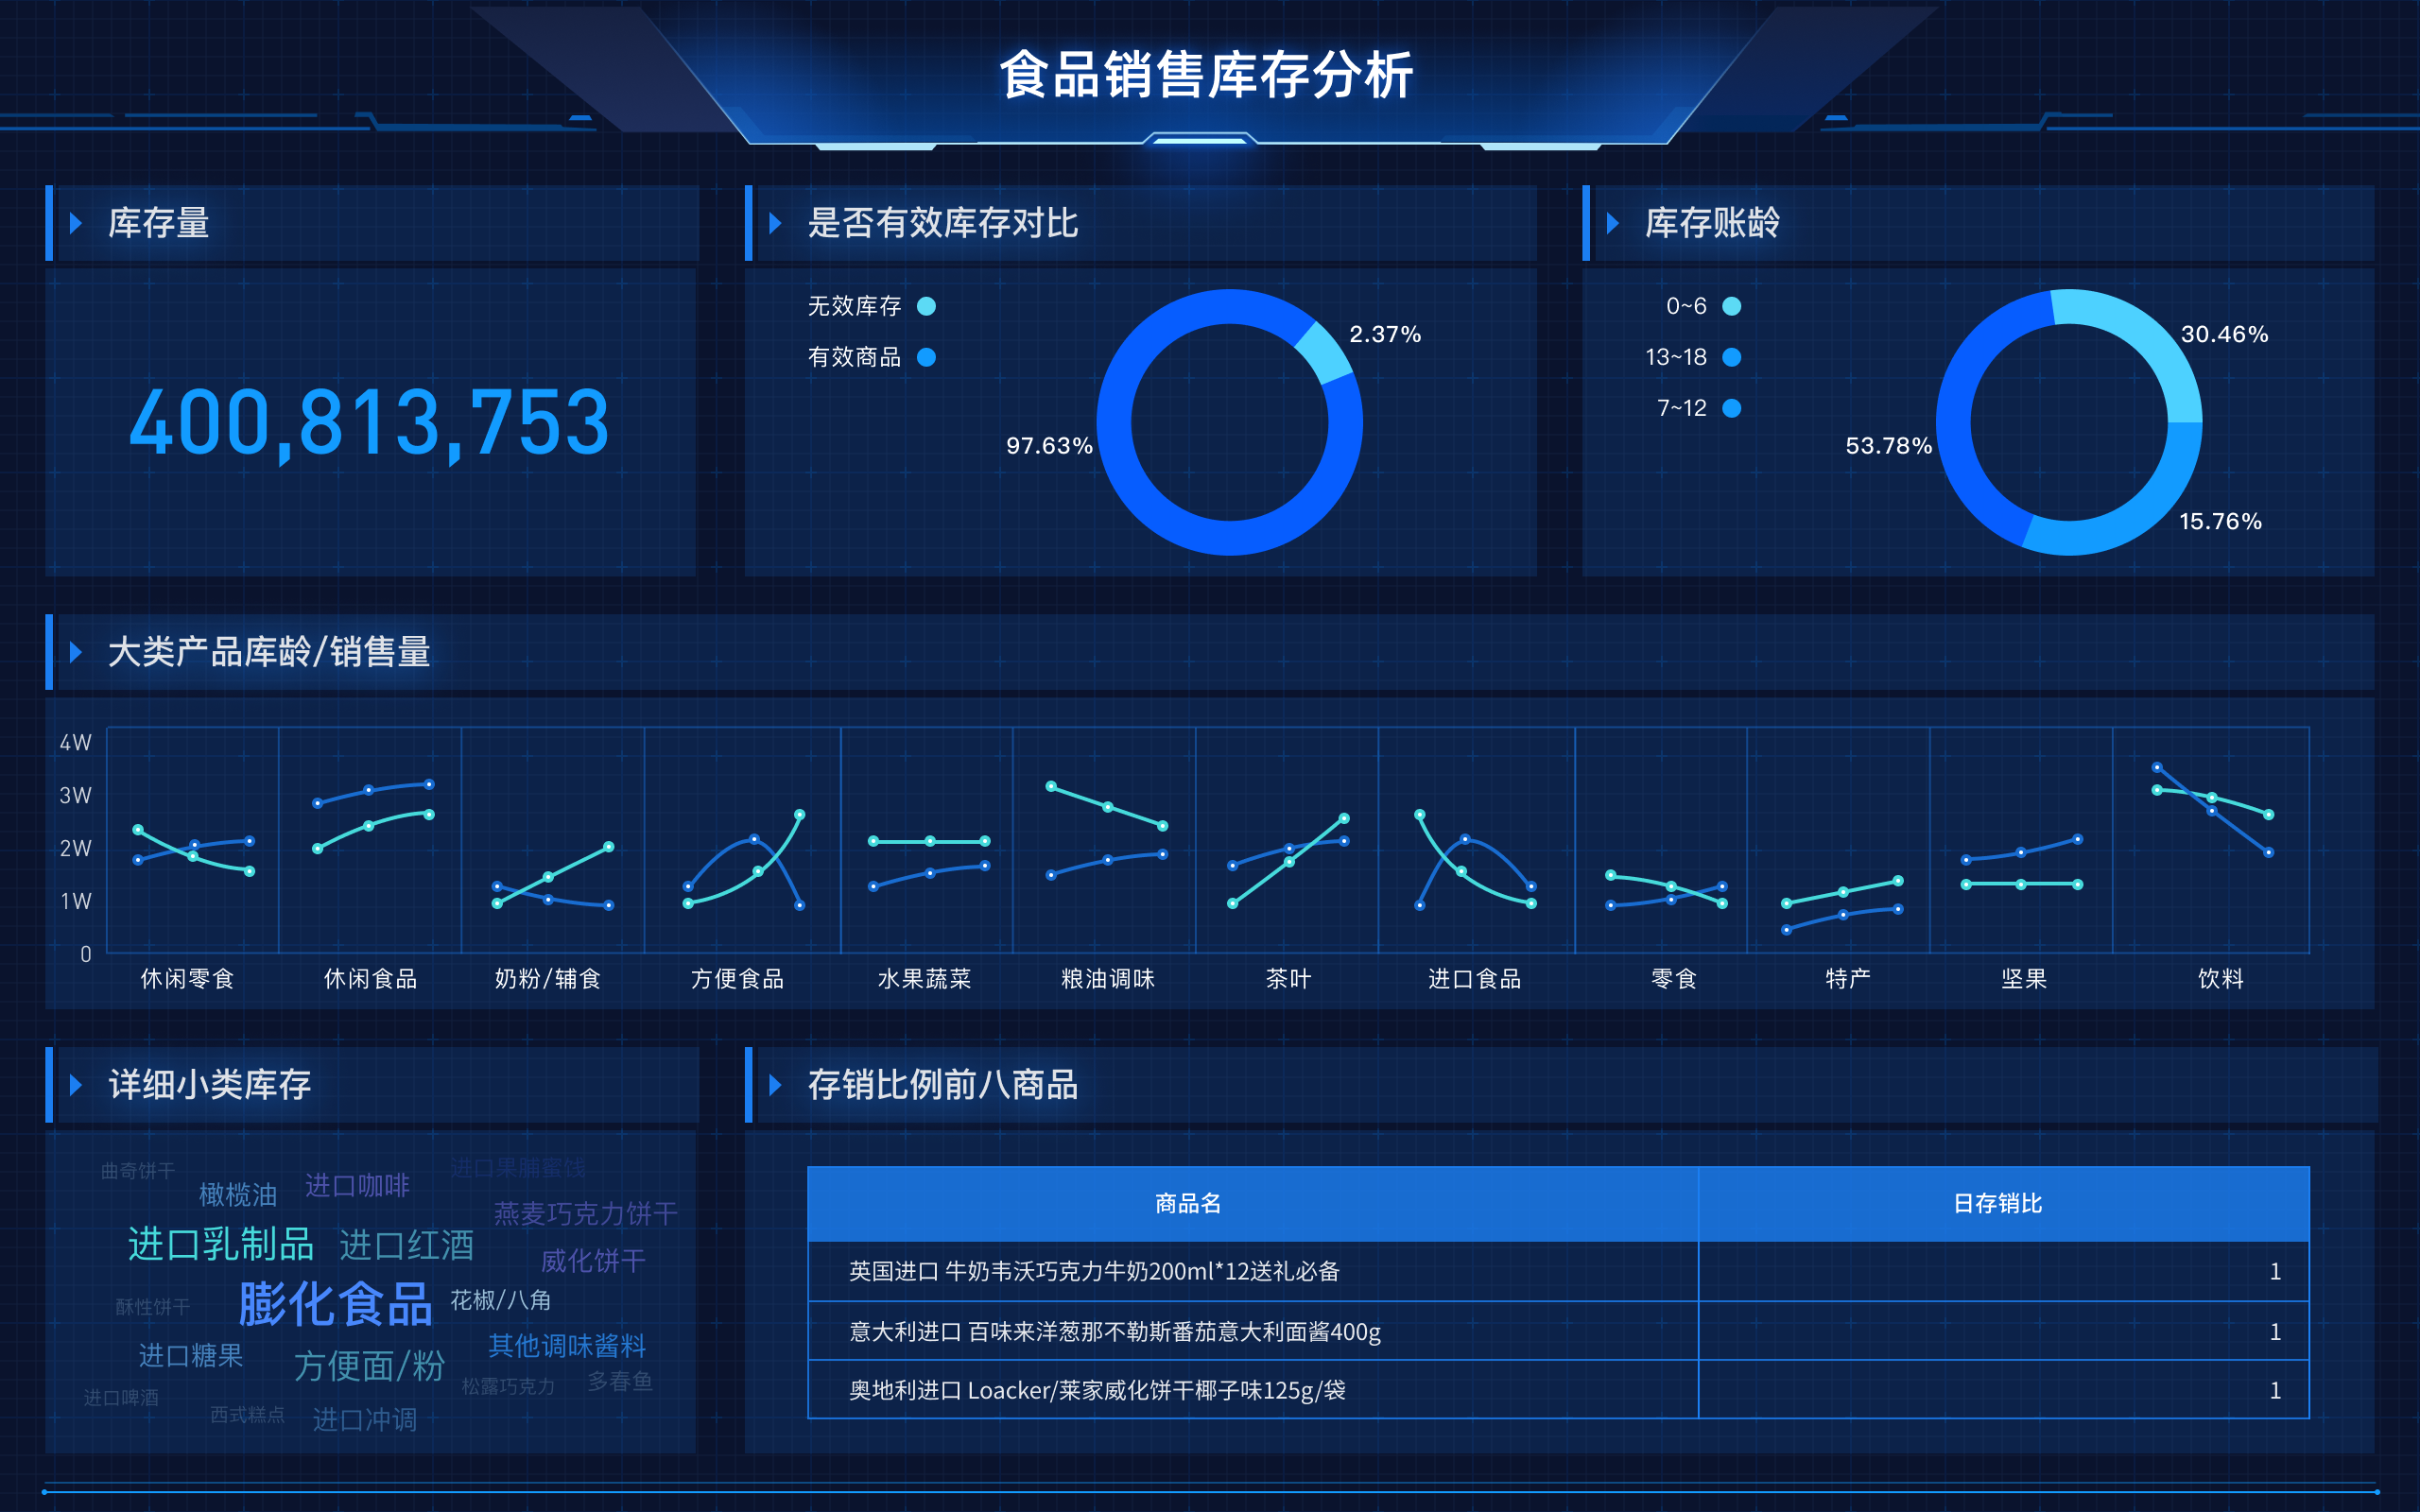
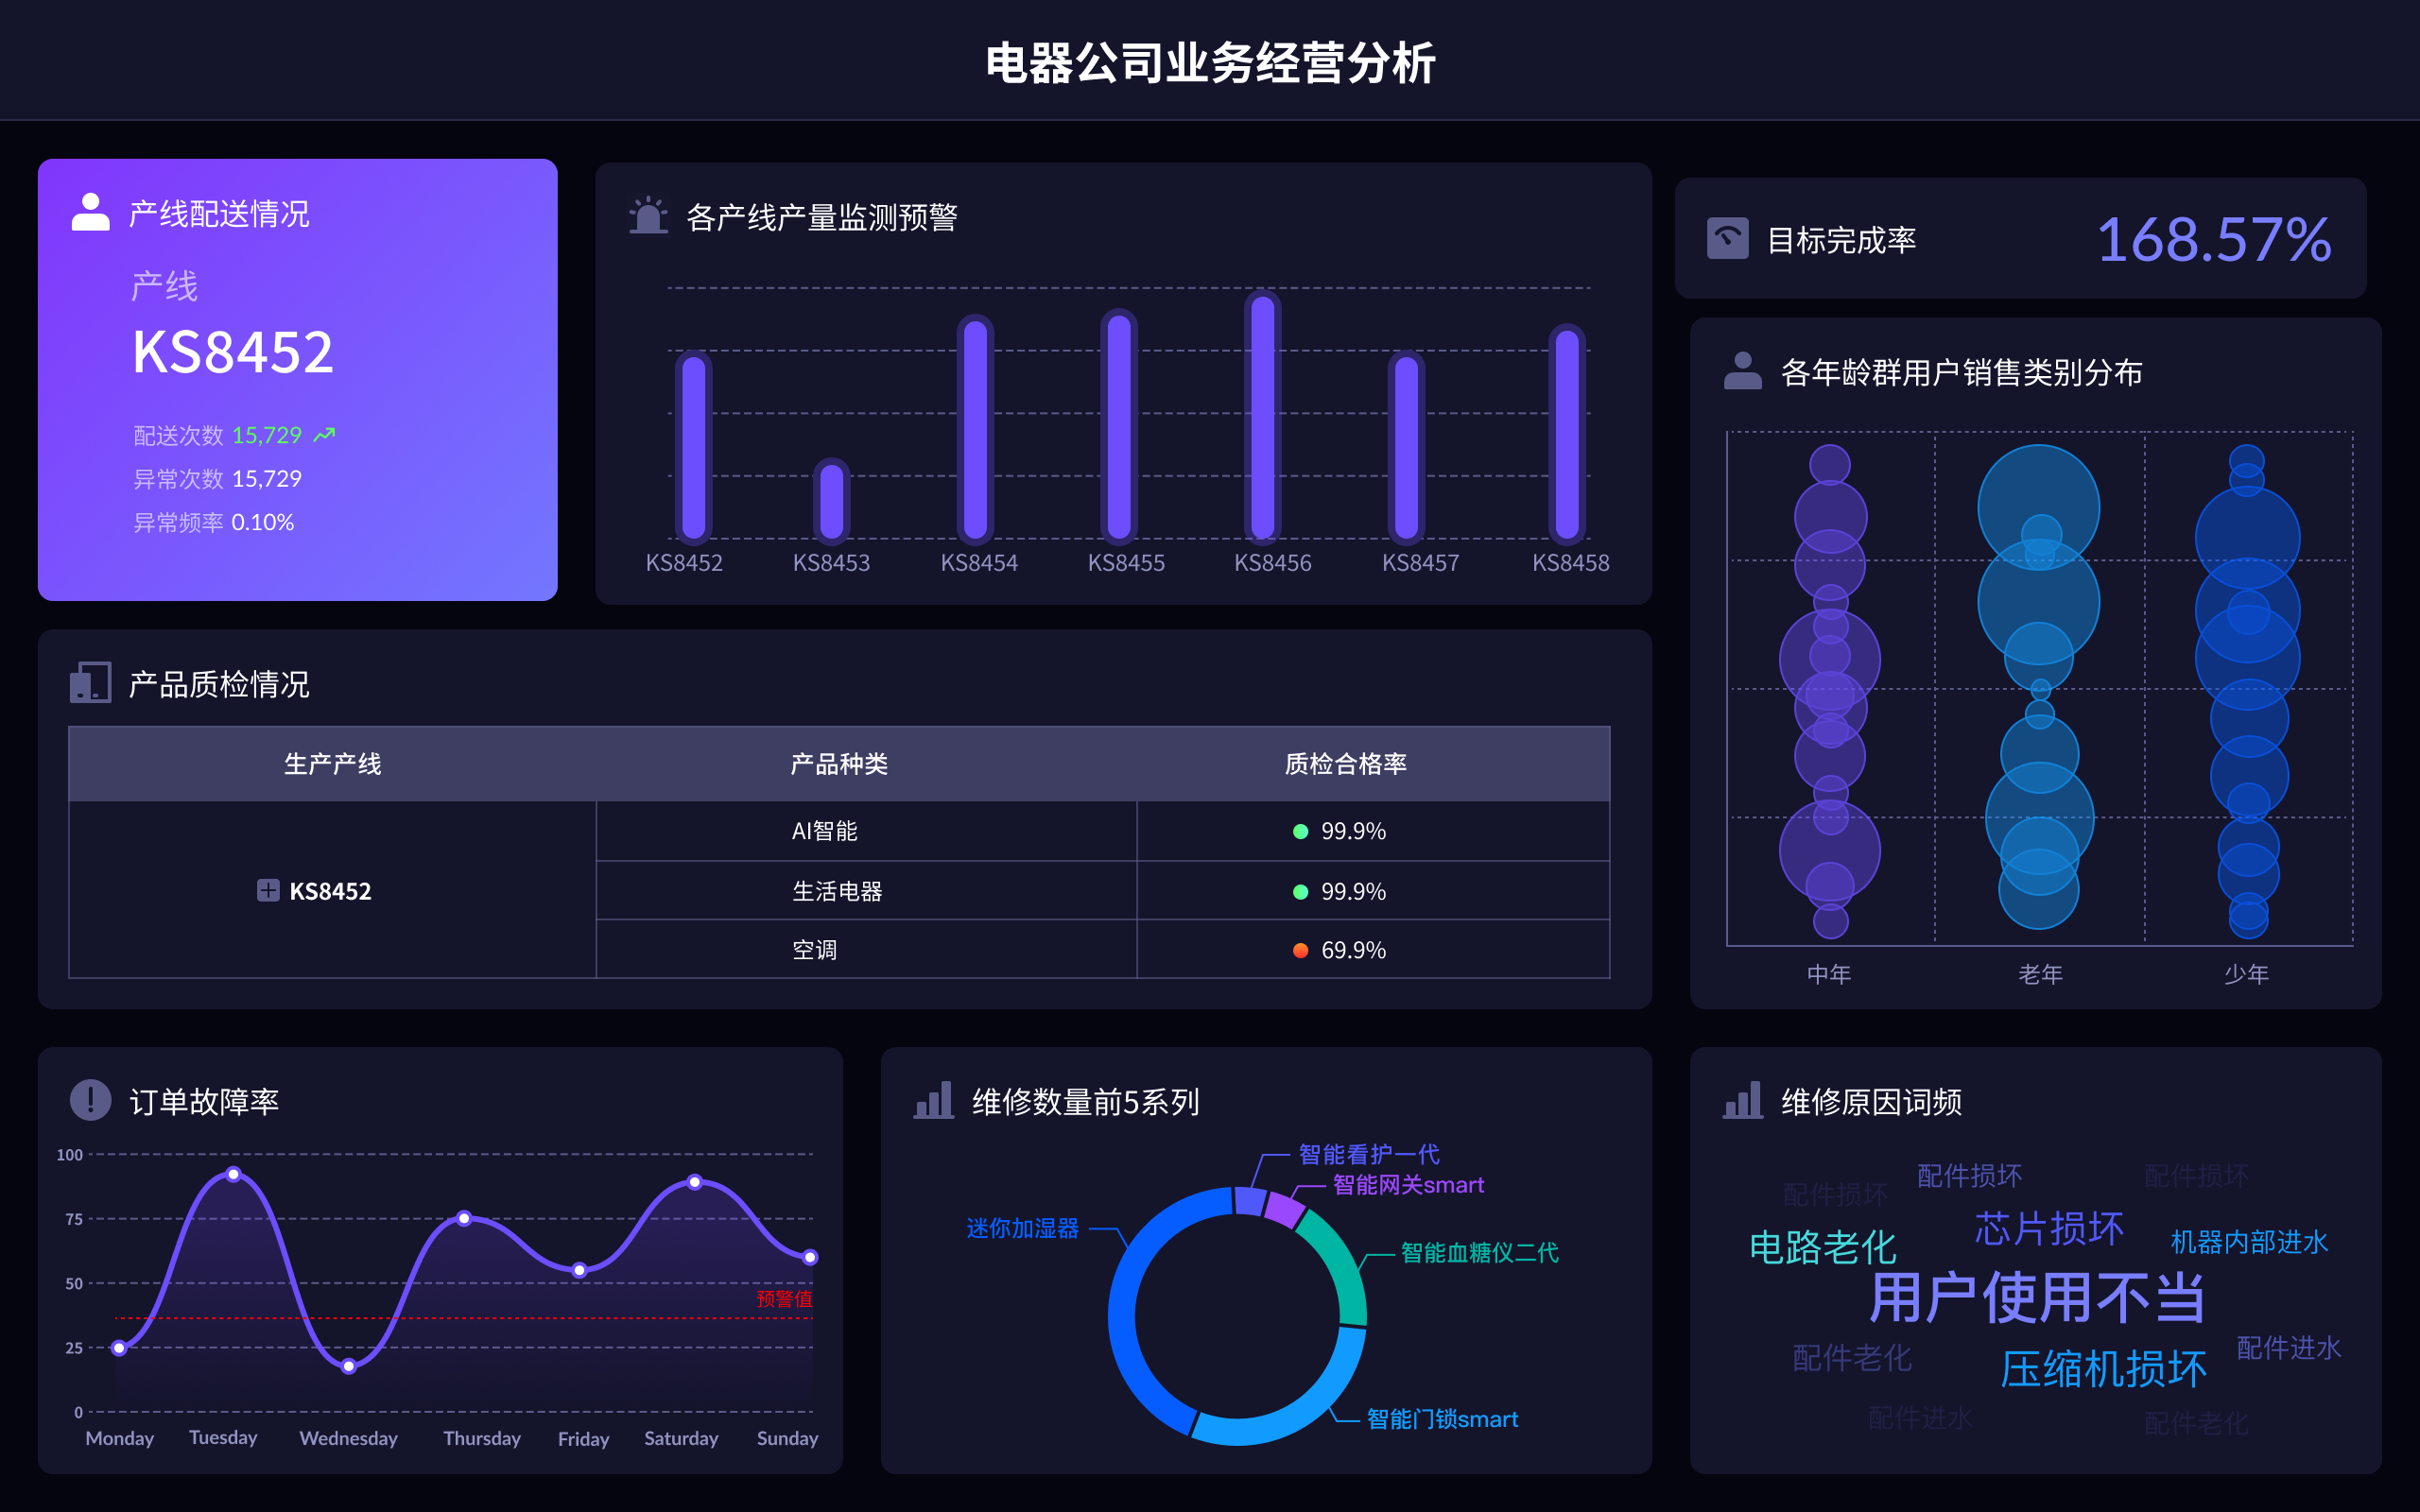
数据分析模块的编写通常包括数据的获取、清洗、分析和可视化等几个步骤。、在实际操作中,数据分析可以使用多种编程语言和工具,如Python、R、SQL等。Python是一种非常流行的数据分析语言,主要因为其强大的库支持,如Pandas、NumPy和Matplotlib等。下面将详细讲解如何使用Python编写一个基本的数据分析模块。
一、数据获取
数据获取是数据分析的第一步,这一步骤的主要任务是将数据从各种来源导入到我们的分析环境中。数据可以来自文件(如CSV、Excel)、数据库(如MySQL、PostgreSQL)、API(如RESTful API)等。
1. 从CSV文件中读取数据
import pandas as pd
data = pd.read_csv('data.csv')
print(data.head())
这段代码使用Pandas库从CSV文件中读取数据,并显示前五行记录。
2. 从Excel文件中读取数据
data = pd.read_excel('data.xlsx')
print(data.head())
这段代码使用Pandas库从Excel文件中读取数据,并显示前五行记录。
3. 从数据库中读取数据
import pymysql
connection = pymysql.connect(host='localhost',
                             user='user',
                             password='passwd',
                             db='database')
query = 'SELECT * FROM table'
data = pd.read_sql(query, connection)
print(data.head())
这段代码使用pymysql库连接到MySQL数据库,并使用Pandas库读取数据。
二、数据清洗
数据清洗是数据分析中非常重要的一步。在这一步中,我们需要处理缺失值、重复值和异常值,并将数据转换为适当的格式以便进一步分析。
1. 处理缺失值
data.dropna(inplace=True)  # 删除包含缺失值的行
或者
data.fillna(0, inplace=True)  # 用0填充缺失值
2. 处理重复值
data.drop_duplicates(inplace=True)
3. 处理异常值
# 例如,使用Z-score方法检测异常值
from scipy import stats
data = data[(np.abs(stats.zscore(data)) < 3).all(axis=1)]
三、数据分析
数据分析是数据分析模块的核心部分。这一步骤的主要任务是通过统计分析、机器学习等方法,从数据中提取有价值的信息。
1. 描述性统计分析
print(data.describe())
这段代码输出数据的描述性统计信息,如平均值、标准差、最小值、最大值等。
2. 数据可视化
import matplotlib.pyplot as plt
data['column'].hist()
plt.show()
这段代码使用Matplotlib库绘制数据的直方图。
3. 机器学习模型
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
X = data[['feature1', 'feature2']]
y = data['target']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
model = LinearRegression()
model.fit(X_train, y_train)
predictions = model.predict(X_test)
print(predictions)
这段代码使用Scikit-learn库训练一个线性回归模型,并进行预测。
四、数据可视化
数据可视化是数据分析的重要部分,通过图形化的方式展示数据和分析结果,可以更直观地发现数据中的模式和趋势。
1. 条形图
data['column'].value_counts().plot(kind='bar')
plt.show()
这段代码使用Pandas和Matplotlib绘制条形图。
2. 散点图
data.plot(kind='scatter', x='feature1', y='feature2')
plt.show()
这段代码使用Pandas和Matplotlib绘制散点图。
3. 折线图
data['column'].plot(kind='line')
plt.show()
这段代码使用Pandas和Matplotlib绘制折线图。
五、FineBI的使用
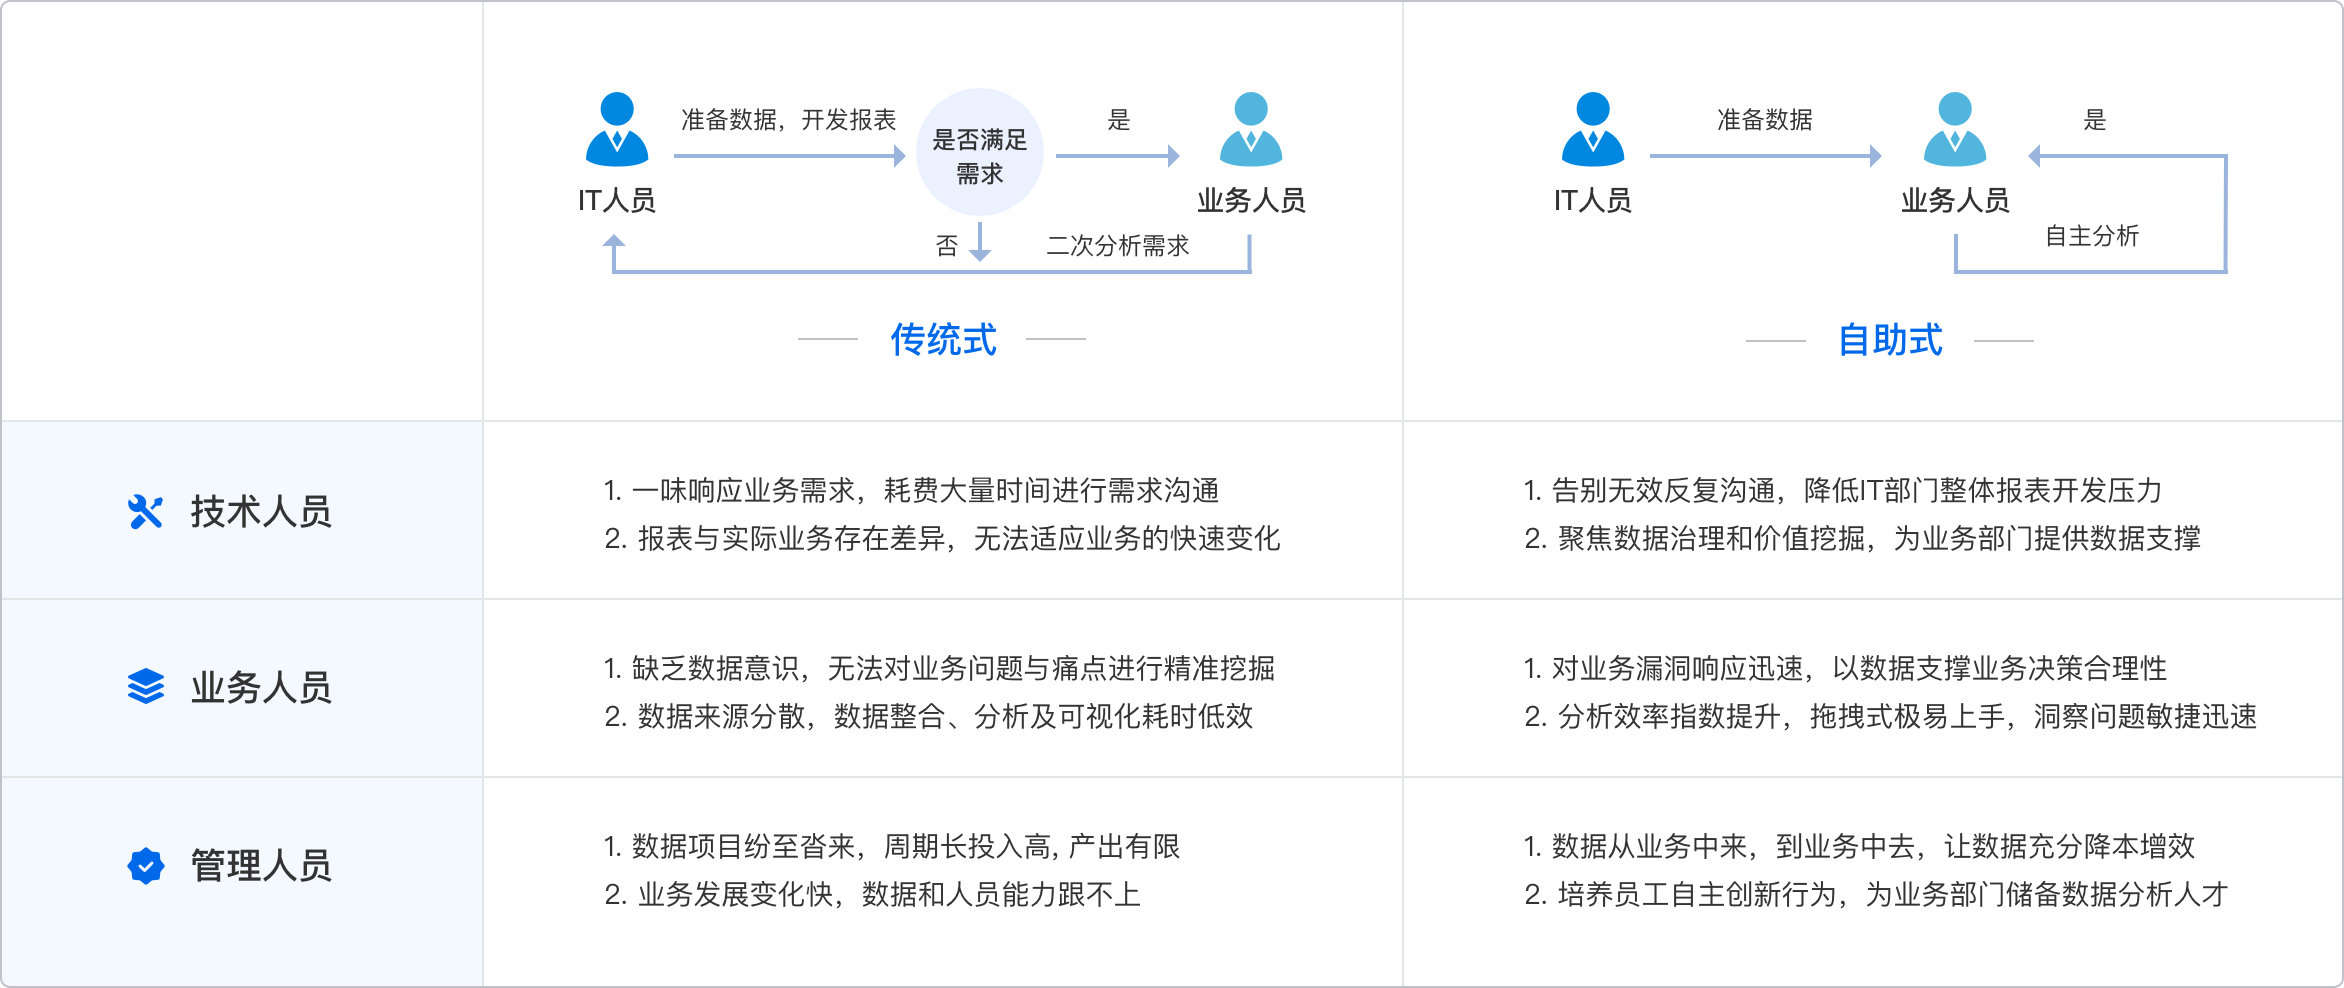
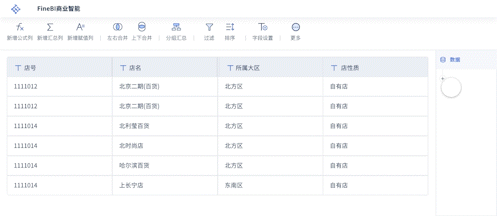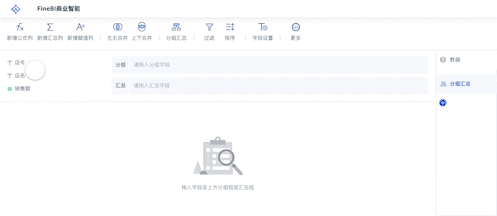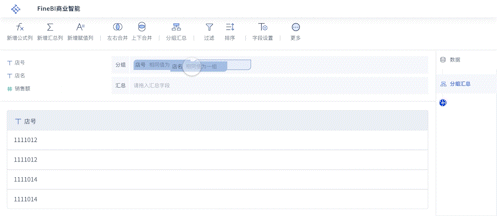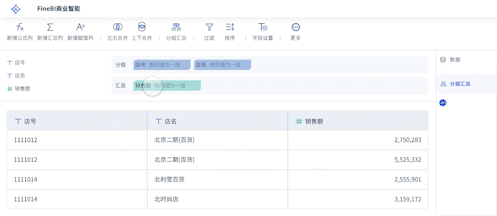
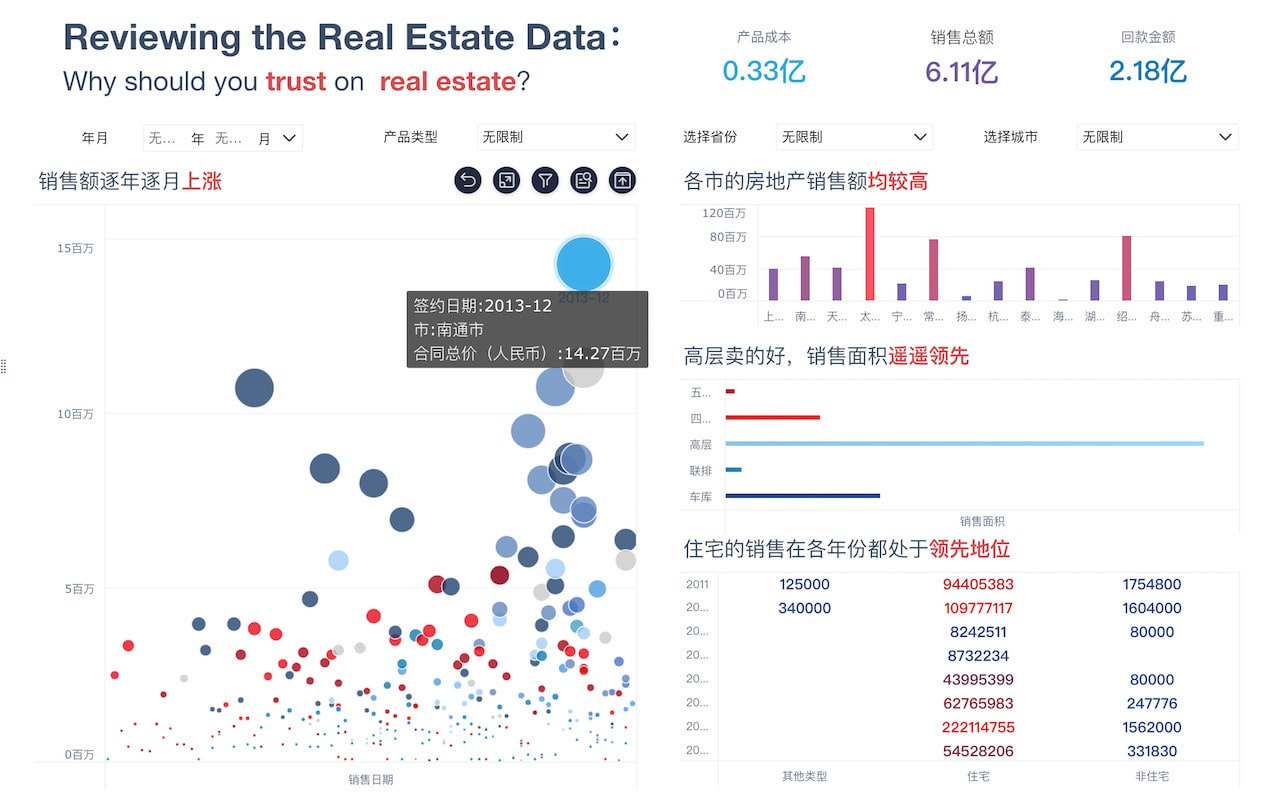
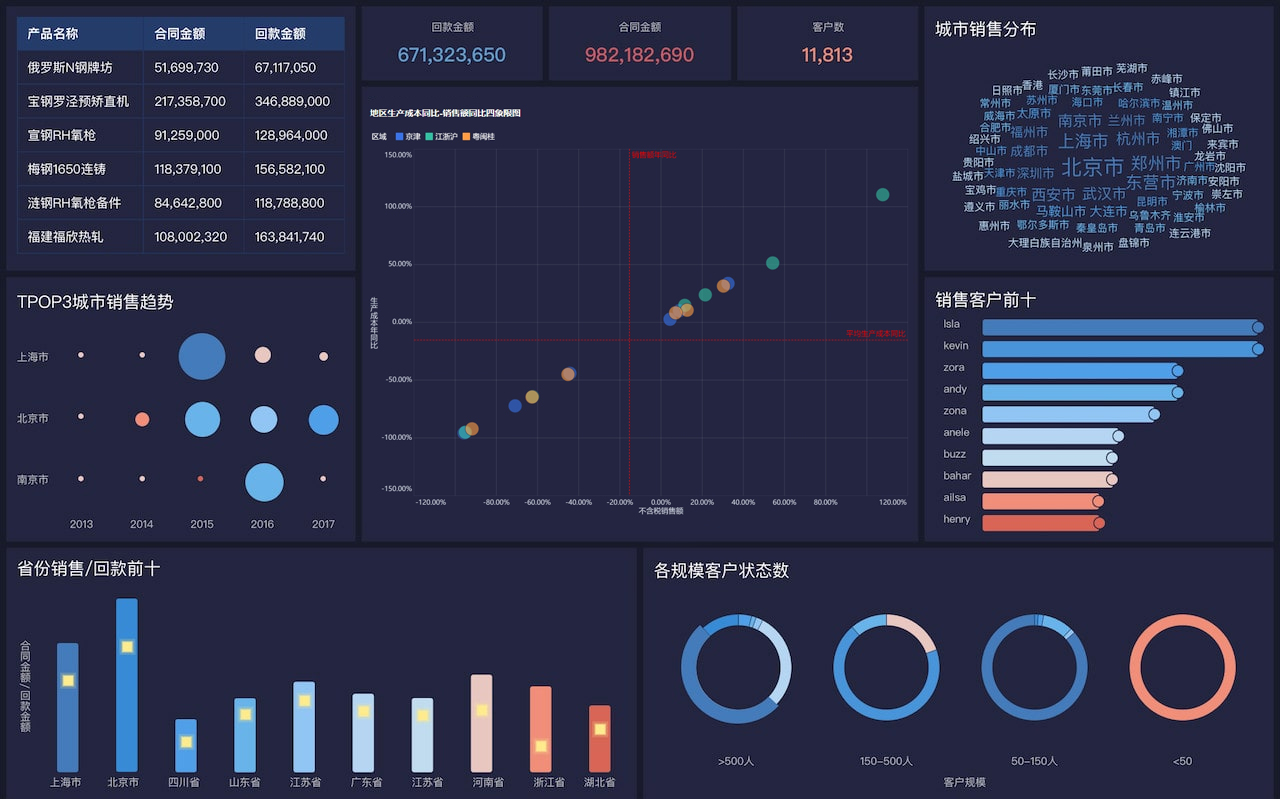
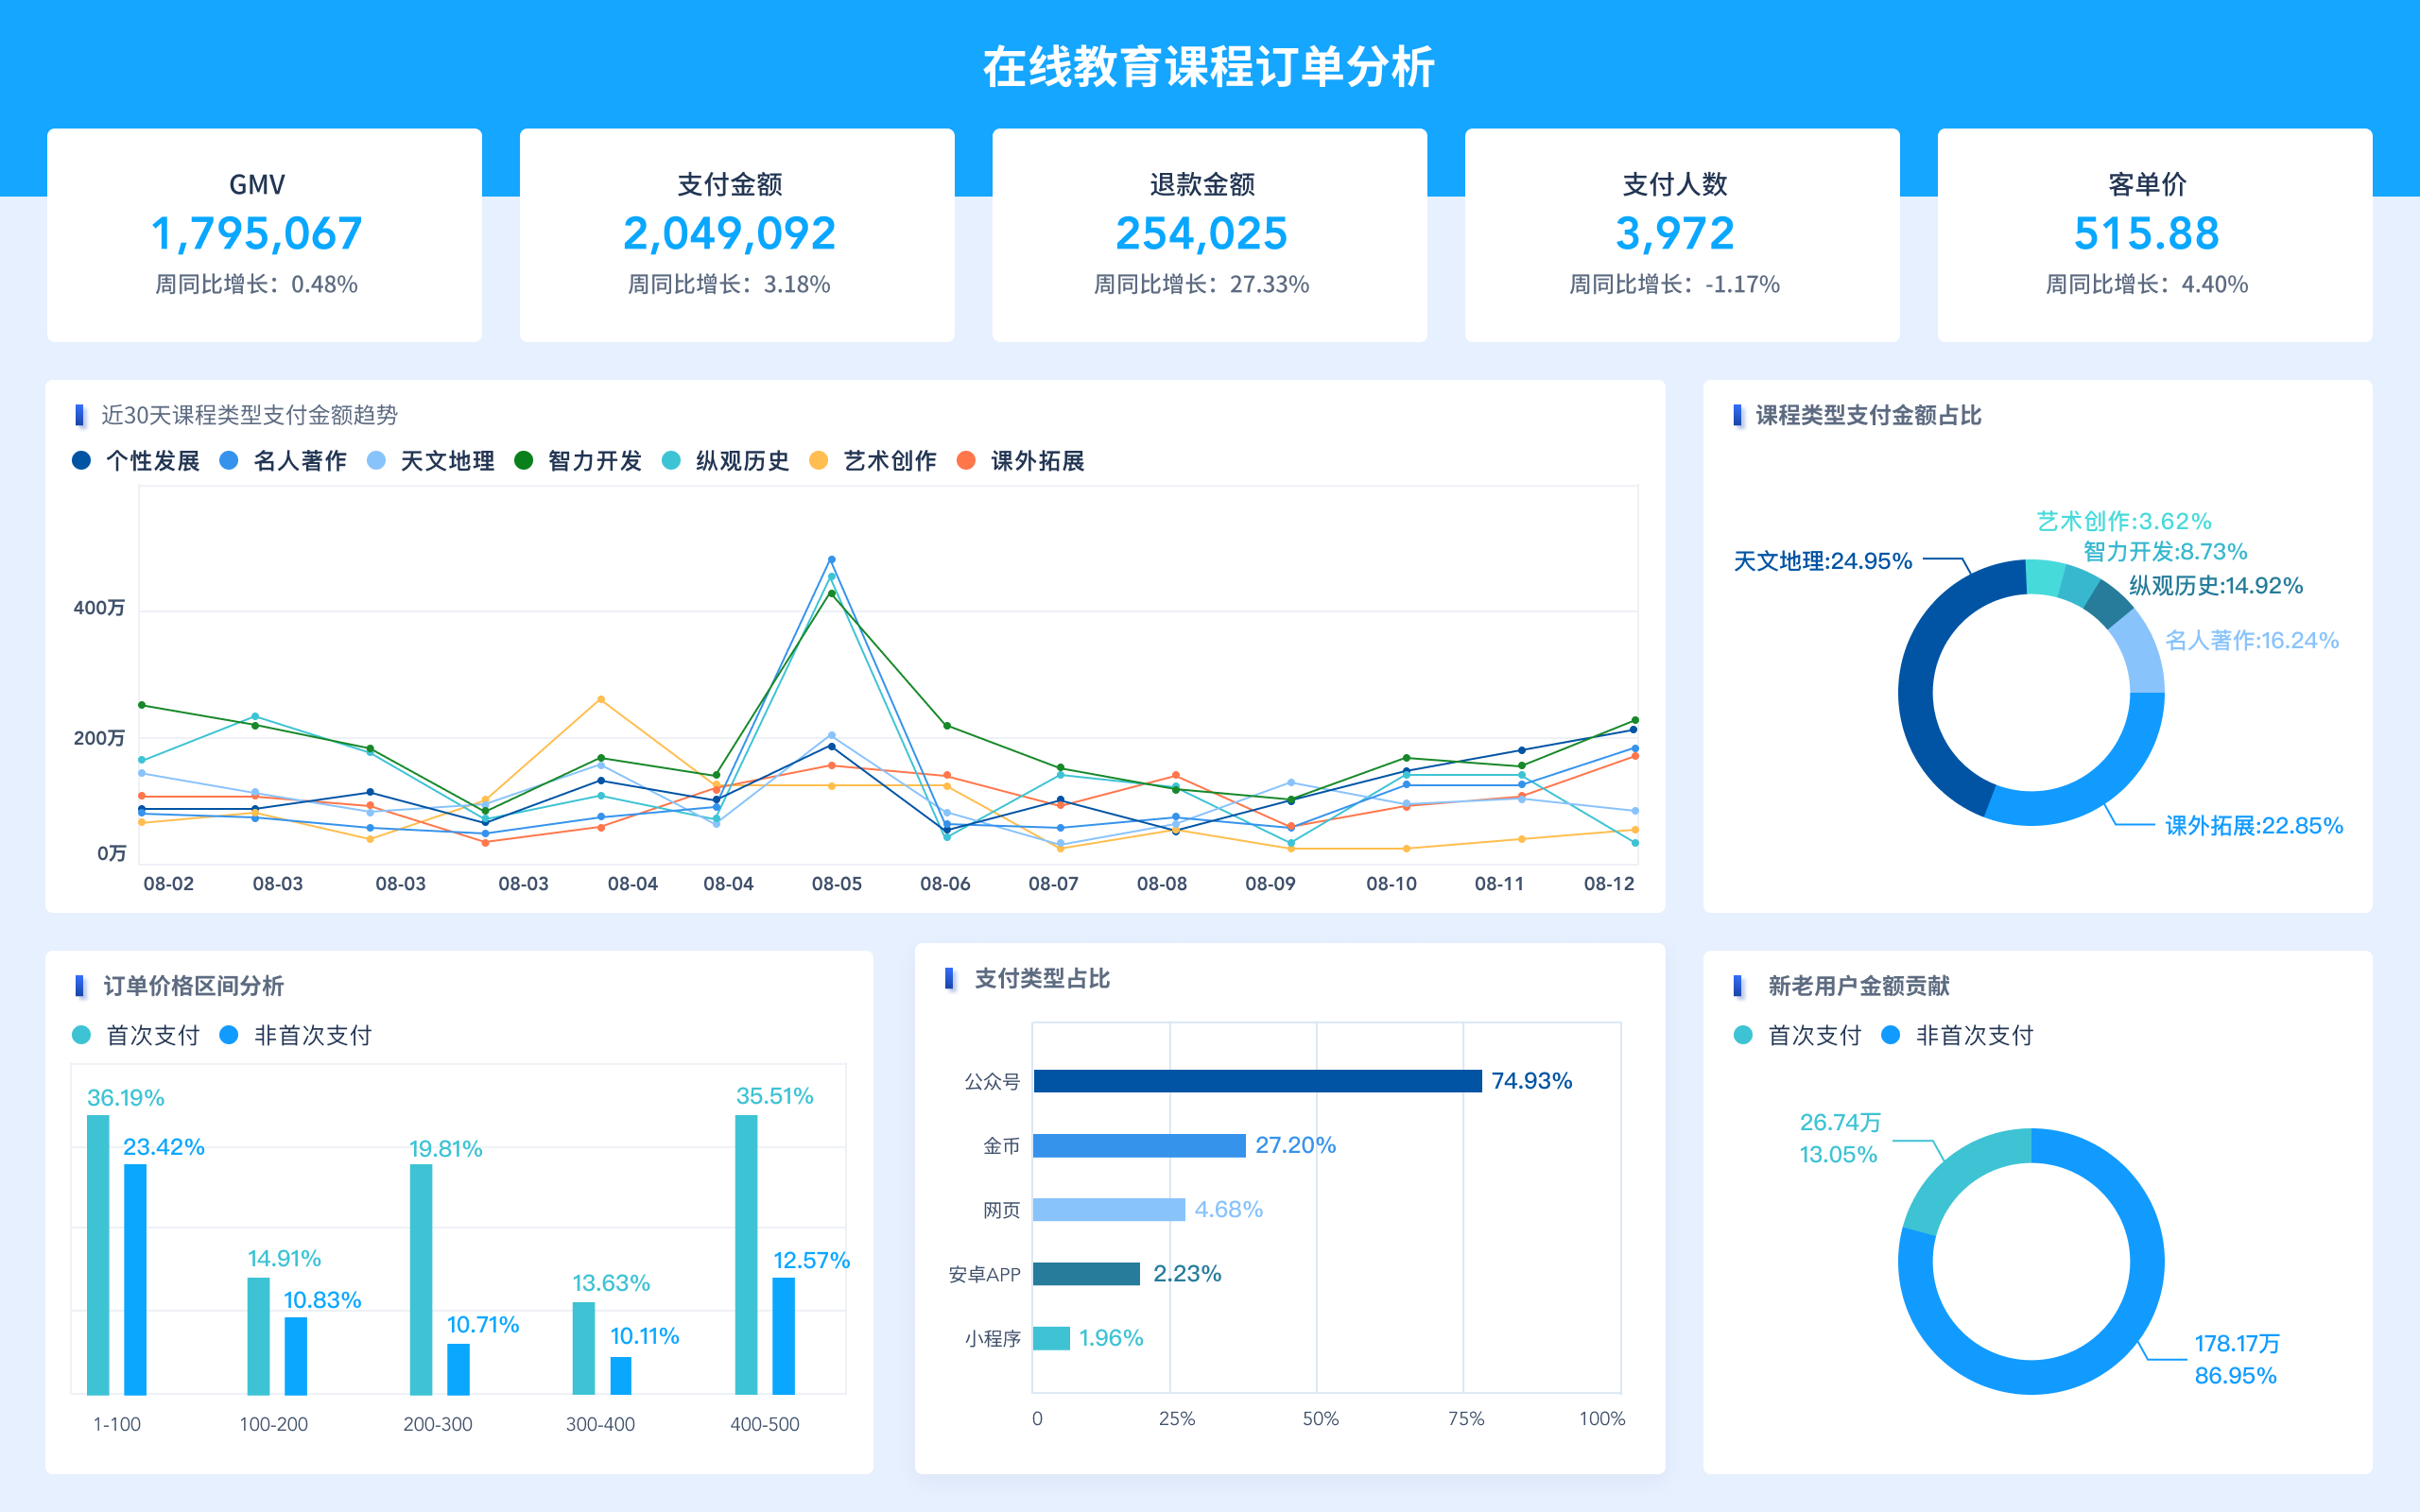
FineBI 是帆软旗下的一款数据分析和商业智能工具,具有强大的数据处理和可视化能力。使用FineBI可以更加便捷地进行数据分析和展示。
-
数据连接与导入
FineBI支持多种数据源的连接,如MySQL、SQL Server、Oracle等,可以轻松导入数据。
-
数据清洗与转换
FineBI提供了丰富的数据清洗和转换功能,可以方便地进行数据预处理。
-
数据分析与建模
FineBI支持多种数据分析方法和机器学习模型,可以快速构建分析模型。
-
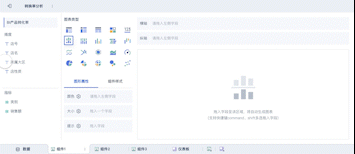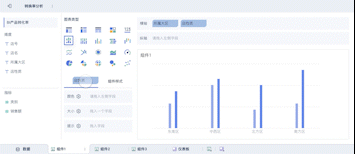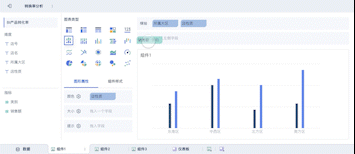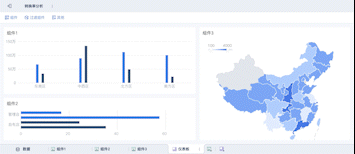
数据可视化
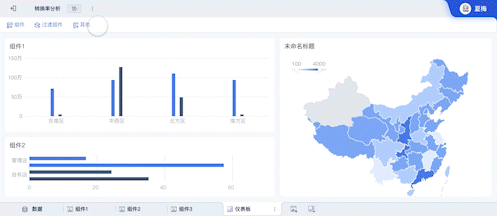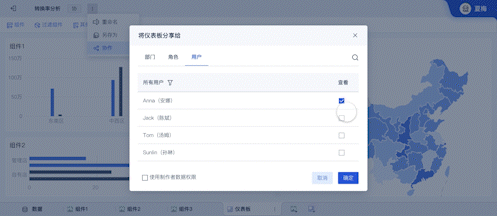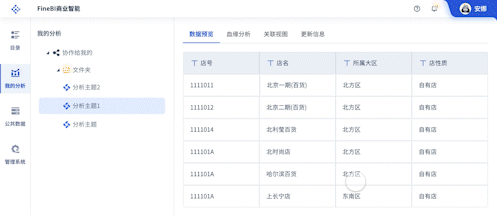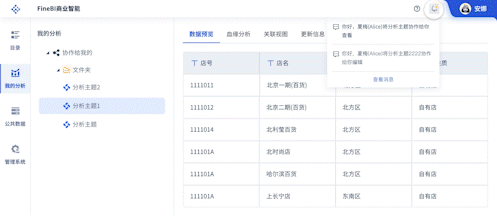
FineBI提供了丰富的图表类型和可视化组件,可以轻松创建各种图表和仪表盘。
-
分享与协作
FineBI支持数据的分享与协作,可以将分析结果分享给团队成员,共同进行数据分析。
通过上述步骤,可以使用FineBI快速构建数据分析模块,实现数据的获取、清洗、分析和可视化。FineBI官网: https://s.fanruan.com/f459r;
六、总结与展望
数据分析模块的编写是一个综合性的过程,涉及数据的获取、清洗、分析和可视化等多个环节。使用Python和FineBI等工具,可以大大简化数据分析的流程,提高分析的效率和准确性。在实际工作中,可以根据具体的需求和数据情况,选择合适的工具和方法进行数据分析。未来,随着数据量和数据复杂度的不断增加,数据分析技术也将不断发展和进步,为企业和个人带来更多的价值和机遇。
相关问答FAQs:
数据分析模块怎么写程序的代码?
在现代数据驱动的世界中,数据分析模块的编写是一个至关重要的技能。这个过程涉及到从数据获取、数据清洗到数据建模和可视化的多个步骤。以下是一些常见的编程语言和工具,以及如何在这些环境中编写数据分析模块的基本步骤。
-
选择编程语言和工具:
数据分析通常使用Python、R、SQL等编程语言。Python因其强大的数据处理库(如Pandas、NumPy、Matplotlib、Seaborn等)而受到广泛欢迎。R则以其统计分析能力著称。SQL是用于数据库查询的重要工具。 -
数据获取:
数据获取是数据分析的第一步。可以通过API、数据库、Excel文件、CSV文件等方式获取数据。Python的pandas库提供了读取多种格式数据的功能,例如:import pandas as pd # 从CSV文件读取数据 data = pd.read_csv('data.csv') # 从Excel文件读取数据 data = pd.read_excel('data.xlsx') -
数据清洗:
数据清洗是确保数据质量的重要步骤。常见的数据清洗操作包括处理缺失值、去除重复数据、数据类型转换等。例如:# 处理缺失值 data.fillna(0, inplace=True) # 去除重复行 data.drop_duplicates(inplace=True) # 数据类型转换 data['date'] = pd.to_datetime(data['date']) -
数据分析:
在数据清洗后,可以进行数据分析,包括描述性统计分析、探索性数据分析等。使用pandas可以轻松实现:# 描述性统计 summary = data.describe() # 分组分析 group_data = data.groupby('category').mean() -
数据可视化:
数据可视化是展示分析结果的重要方式。Python中常用的可视化库有Matplotlib和Seaborn。通过这些库,可以创建直观的图表:import matplotlib.pyplot as plt import seaborn as sns # 绘制散点图 plt.scatter(data['x'], data['y']) plt.title('Scatter Plot') plt.xlabel('X-axis') plt.ylabel('Y-axis') plt.show() # 绘制箱型图 sns.boxplot(x='category', y='value', data=data) plt.title('Box Plot by Category') plt.show() -
建模与预测:
在数据分析的高级阶段,可以使用机器学习模型进行预测。scikit-learn是一个非常流行的库,适用于各种机器学习任务。例如,构建一个简单的线性回归模型:from sklearn.model_selection import train_test_split from sklearn.linear_model import LinearRegression # 划分训练集和测试集 X = data[['feature1', 'feature2']] y = data['target'] X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2) # 训练模型 model = LinearRegression() model.fit(X_train, y_train) # 进行预测 predictions = model.predict(X_test) -
代码优化与自动化:
为了提高代码的可读性和可维护性,可以将数据分析的过程封装成函数或类。此外,使用Jupyter Notebook可以方便地进行实验和展示结果,适合数据分析工作。 -
文档与共享:
编写良好的文档是确保代码可用性的重要部分。可以使用Markdown或R Markdown进行文档撰写,并将代码和结果共享到GitHub等平台,便于团队协作。
数据分析模块的编程语言有哪些?
数据分析模块可以使用多种编程语言来构建,不同的语言在功能和特性上各有优势。以下是一些常用的编程语言及其特点:
-
Python:
Python因其简单易学和强大的数据分析库而广受欢迎。其主要库包括:- Pandas:用于数据处理和分析,提供灵活的数据结构。
- NumPy:用于高性能数值计算,支持多维数组。
- Matplotlib和Seaborn:用于数据可视化。
- Scikit-learn:用于机器学习建模。
Python的广泛应用使其成为数据分析领域的首选语言。
-
R:
R语言专为统计分析和数据可视化设计。它的优势在于:- 丰富的统计分析功能,适合学术研究和数据科学。
- 强大的可视化能力,ggplot2等包可以生成高质量图表。
- 大量的统计模型和算法,适用于各种数据分析任务。
R特别适合那些需要复杂统计分析的项目。
-
SQL:
SQL(结构化查询语言)用于数据库管理和数据查询。它的特点包括:- 高效的数据检索和处理,适合大规模数据集。
- 可以轻松进行数据筛选、分组和聚合操作。
- 与其他编程语言结合使用,如Python和R,以便从数据库中提取数据。
SQL是数据分析过程中不可或缺的工具,尤其在处理关系型数据库时。
-
Julia:
Julia是一种高性能的编程语言,专为数值和科学计算设计。它的特点有:- 速度极快,适合大规模数据分析和复杂计算。
- 易于与其他语言(如Python和R)集成。
- 提供多种库,用于数据分析和可视化。
Julia在需要高效计算的场景中表现出色,但目前的生态系统相对较小。
-
SAS:
SAS是一种专用于数据分析和统计建模的商业软件。它的特点包括:- 强大的数据管理和分析功能,适用于大型企业。
- 提供丰富的统计分析工具和报告功能。
- 用户友好的界面,适合不熟悉编程的用户。
SAS在金融、医疗和市场研究等行业广泛应用。
数据分析模块需要哪些技能?
编写高效的数据分析模块需要掌握多种技能,这些技能不仅包括编程能力,还涵盖数据处理、统计分析和可视化等多个方面。以下是一些关键技能:
-
编程技能:
熟练掌握一种或多种编程语言(如Python、R、SQL等)是进行数据分析的基础。了解语言的基本语法、数据结构和常用库,可以有效提高数据处理的效率。 -
数据处理与清洗:
数据分析的质量很大程度上依赖于数据的质量。掌握数据清洗技巧,如处理缺失值、去除重复数据和数据格式转换,能够帮助分析师获得准确的分析结果。 -
统计分析能力:
了解基本的统计学原理是数据分析的核心。分析师需要掌握描述性统计、推断统计、假设检验等概念,以便进行有效的数据分析和建模。 -
数据可视化能力:
数据可视化不仅有助于分析师理解数据,还有助于向他人展示分析结果。掌握可视化工具和库(如Matplotlib、Seaborn、ggplot2等),能够创建清晰、直观的图表,使数据更易于理解。 -
机器学习基础:
了解机器学习的基本概念和算法(如回归、分类、聚类等)可以帮助分析师在数据分析中引入预测模型,挖掘更深层次的信息。 -
业务理解:
数据分析不仅仅是对数据的处理,还需要结合业务背景理解数据的含义。了解行业趋势、市场动态和业务流程,可以更好地指导数据分析的方向和目标。 -
沟通能力:
数据分析的结果需要与利益相关者进行沟通。良好的沟通能力可以帮助分析师有效地解释分析结果,并提出基于数据的建议。 -
项目管理能力:
数据分析往往是一个复杂的项目,涉及多个环节。掌握项目管理的基本知识,可以帮助分析师更好地组织工作,确保项目按时完成。
这些技能的结合将使数据分析师能够更有效地处理数据,提取有价值的信息,并为决策提供支持。随着数据分析领域的不断发展,保持学习和适应新技术的能力也是非常重要的。
本文内容通过AI工具匹配关键字智能整合而成,仅供参考,帆软不对内容的真实、准确或完整作任何形式的承诺。具体产品功能请以帆软官方帮助文档为准,或联系您的对接销售进行咨询。如有其他问题,您可以通过联系blog@fanruan.com进行反馈,帆软收到您的反馈后将及时答复和处理。