在进行Logistic回归分析时,数据的解读主要包括理解模型的系数、评估模型的拟合优度、解释模型的分类准确性。理解模型的系数是关键一步,它告诉我们自变量对因变量的影响方向和大小。例如,如果一个自变量的系数为正,那么随着该自变量的增加,因变量的概率也会增加。评估模型的拟合优度可以通过查看指标如伪R平方来衡量,它表明模型对数据的解释程度。解释模型的分类准确性则通常通过混淆矩阵、ROC曲线和AUC值来完成,这些指标可以帮助我们判断模型在实际分类任务中的表现。
一、理解模型的系数
在Logistic回归模型中,系数的符号和数值大小可以告诉我们自变量对因变量的影响方向和强度。正系数表示自变量的增加会使因变量发生的概率增加,负系数则表示自变量的增加会使因变量发生的概率减少。系数的大小则表示这种影响的程度。例如,若一个自变量的系数是0.5,则该变量每增加一个单位,因变量发生的概率会增加约50%。需要注意的是,这里的系数是对数几率的变化,因此实际概率的变化需要进一步计算。
二、评估模型的拟合优度
拟合优度是指模型对数据的解释能力,可以通过伪R平方(Pseudo R-squared)等指标来衡量。伪R平方类似于线性回归中的R平方,用于表示模型解释因变量变异的程度。常见的伪R平方包括Cox & Snell R平方和Nagelkerke R平方。虽然伪R平方的值通常低于线性回归中的R平方,但它们仍然是评估模型优劣的重要工具。此外,似然比检验(Likelihood Ratio Test)也可以用于比较模型的拟合优度,通过比较不同模型的似然值,可以判断哪一个模型更适合数据。
三、解释模型的分类准确性
分类准确性是衡量Logistic回归模型在实际分类任务中表现的重要指标,可以通过混淆矩阵、ROC曲线和AUC值来评估。混淆矩阵可以展示模型的预测结果与实际结果的对比情况,从而计算出模型的准确率、召回率和F1值等指标。ROC曲线则通过绘制真正例率(TPR)和假正例率(FPR)来评估模型的分类能力,曲线下的面积(AUC值)越大,模型的分类性能越好。AUC值通常在0.5到1之间,值越接近1表示模型的分类性能越优越。
四、FineBI助力Logistic回归分析
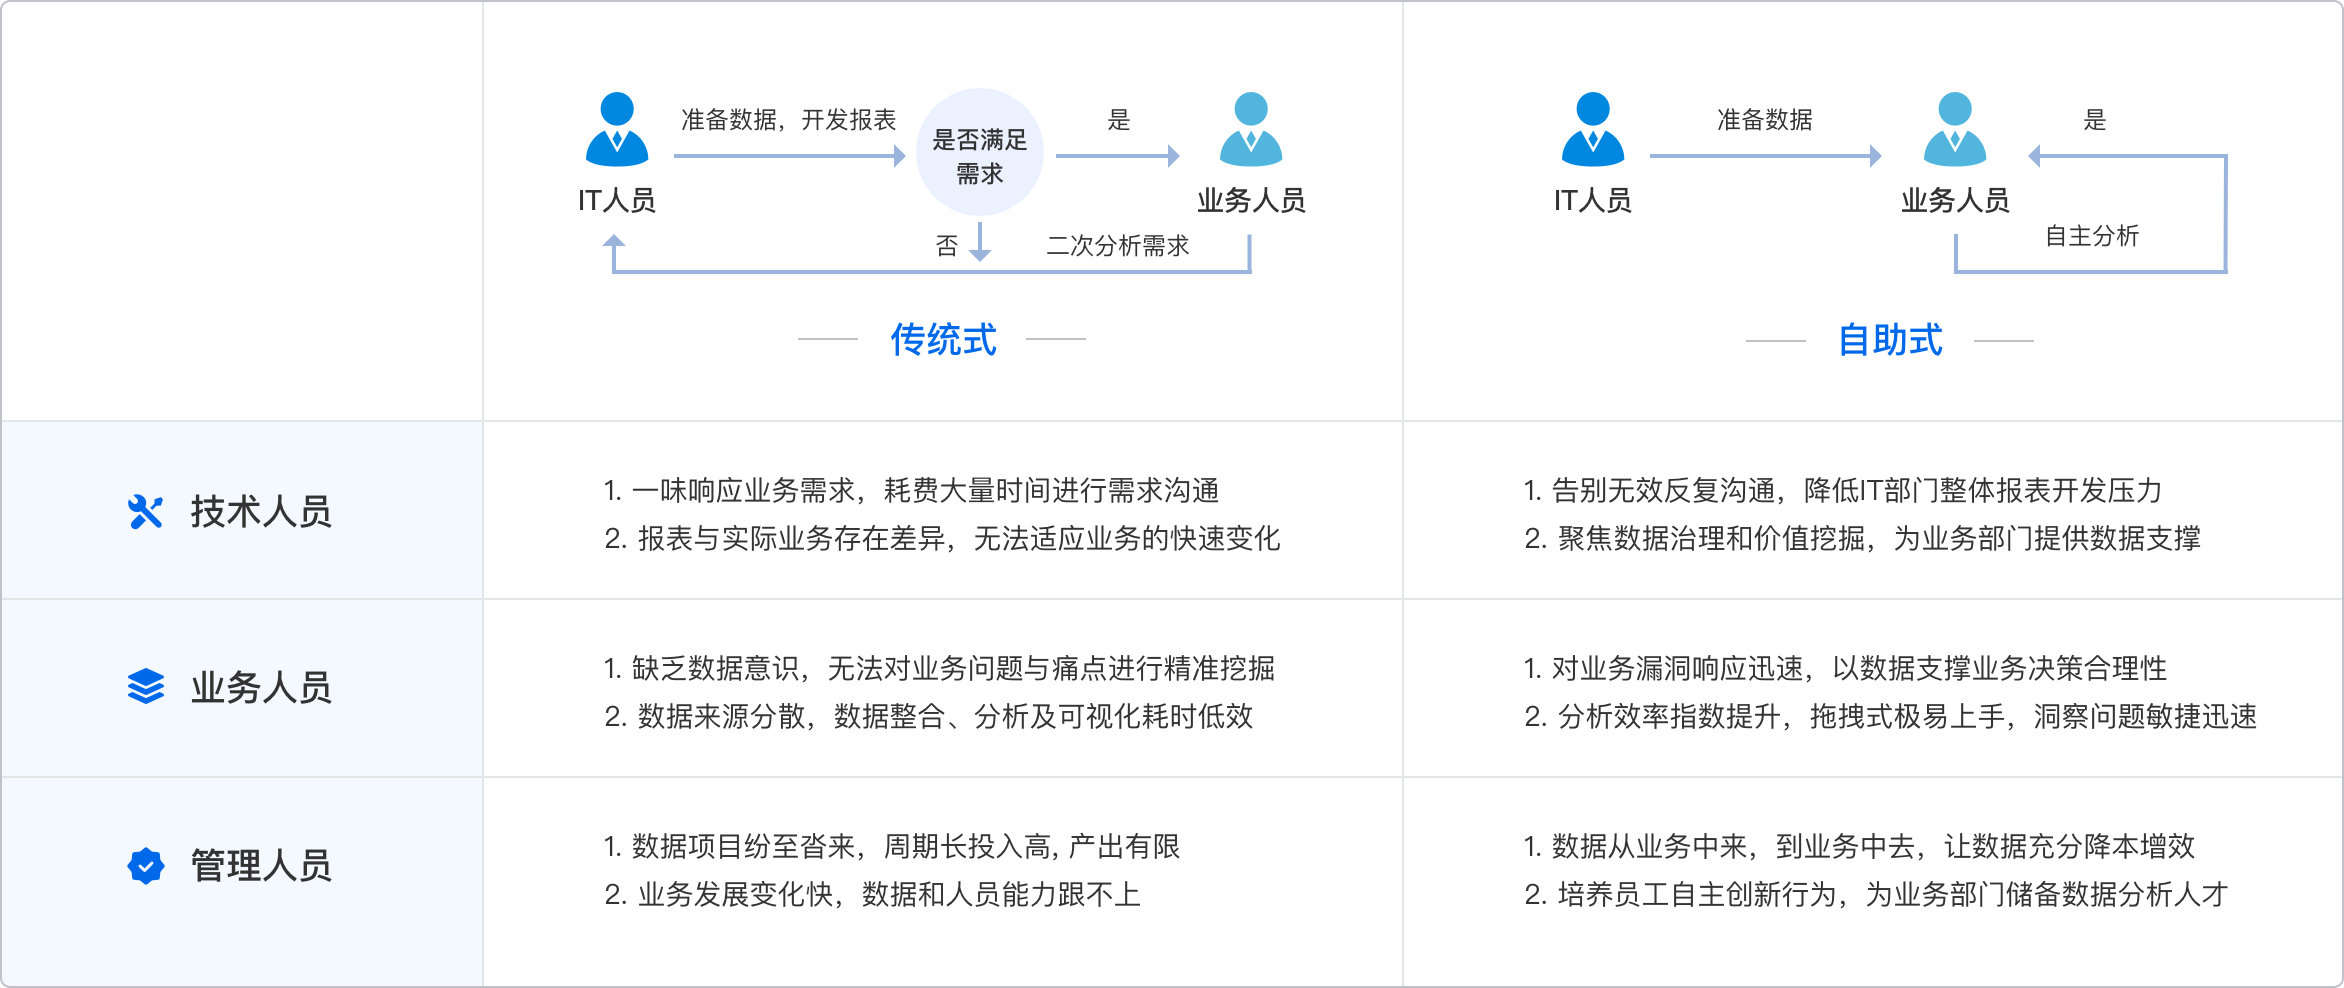
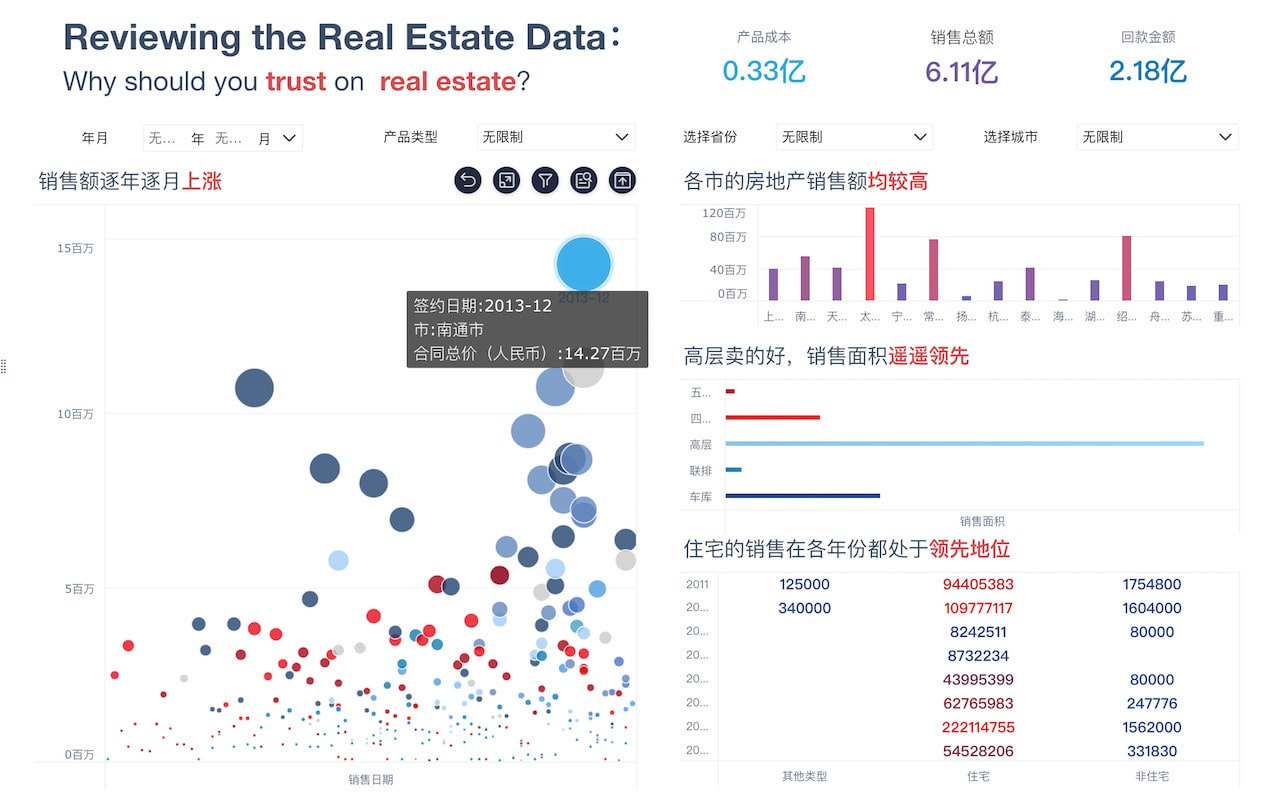
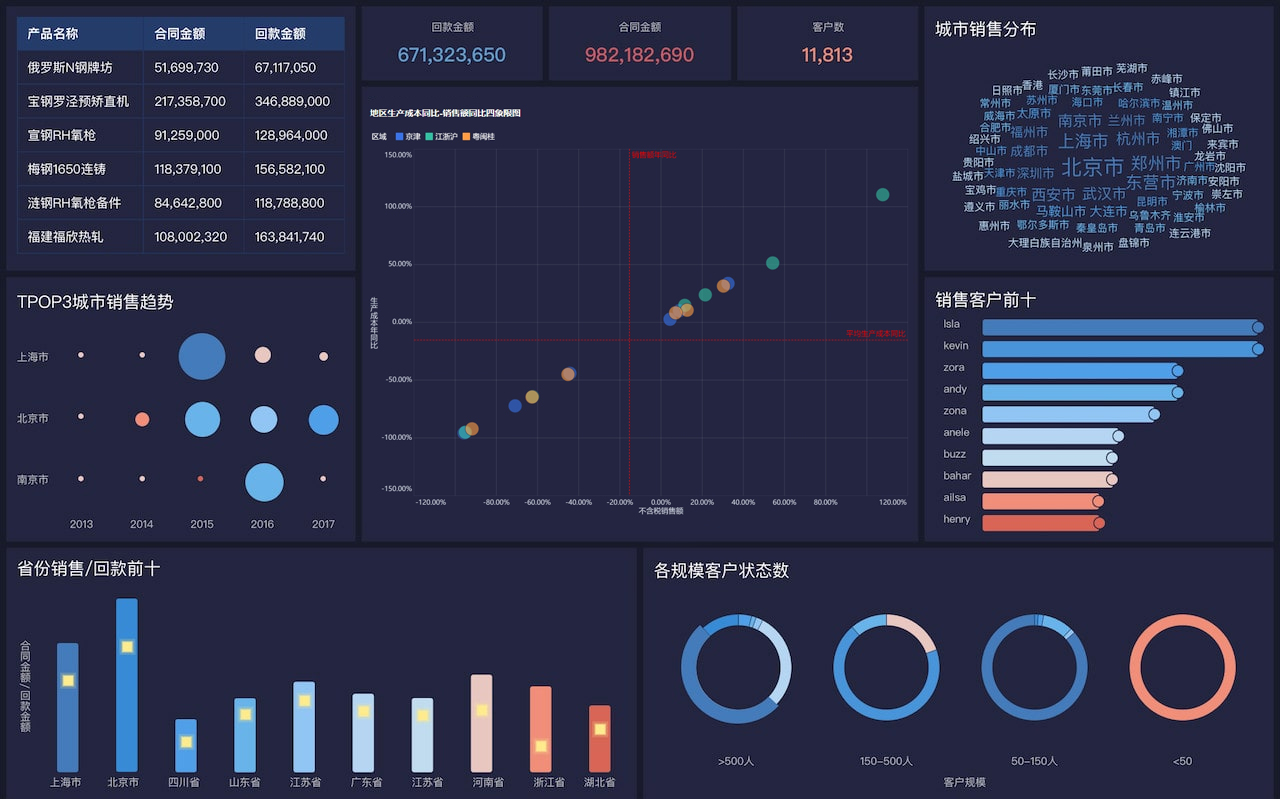
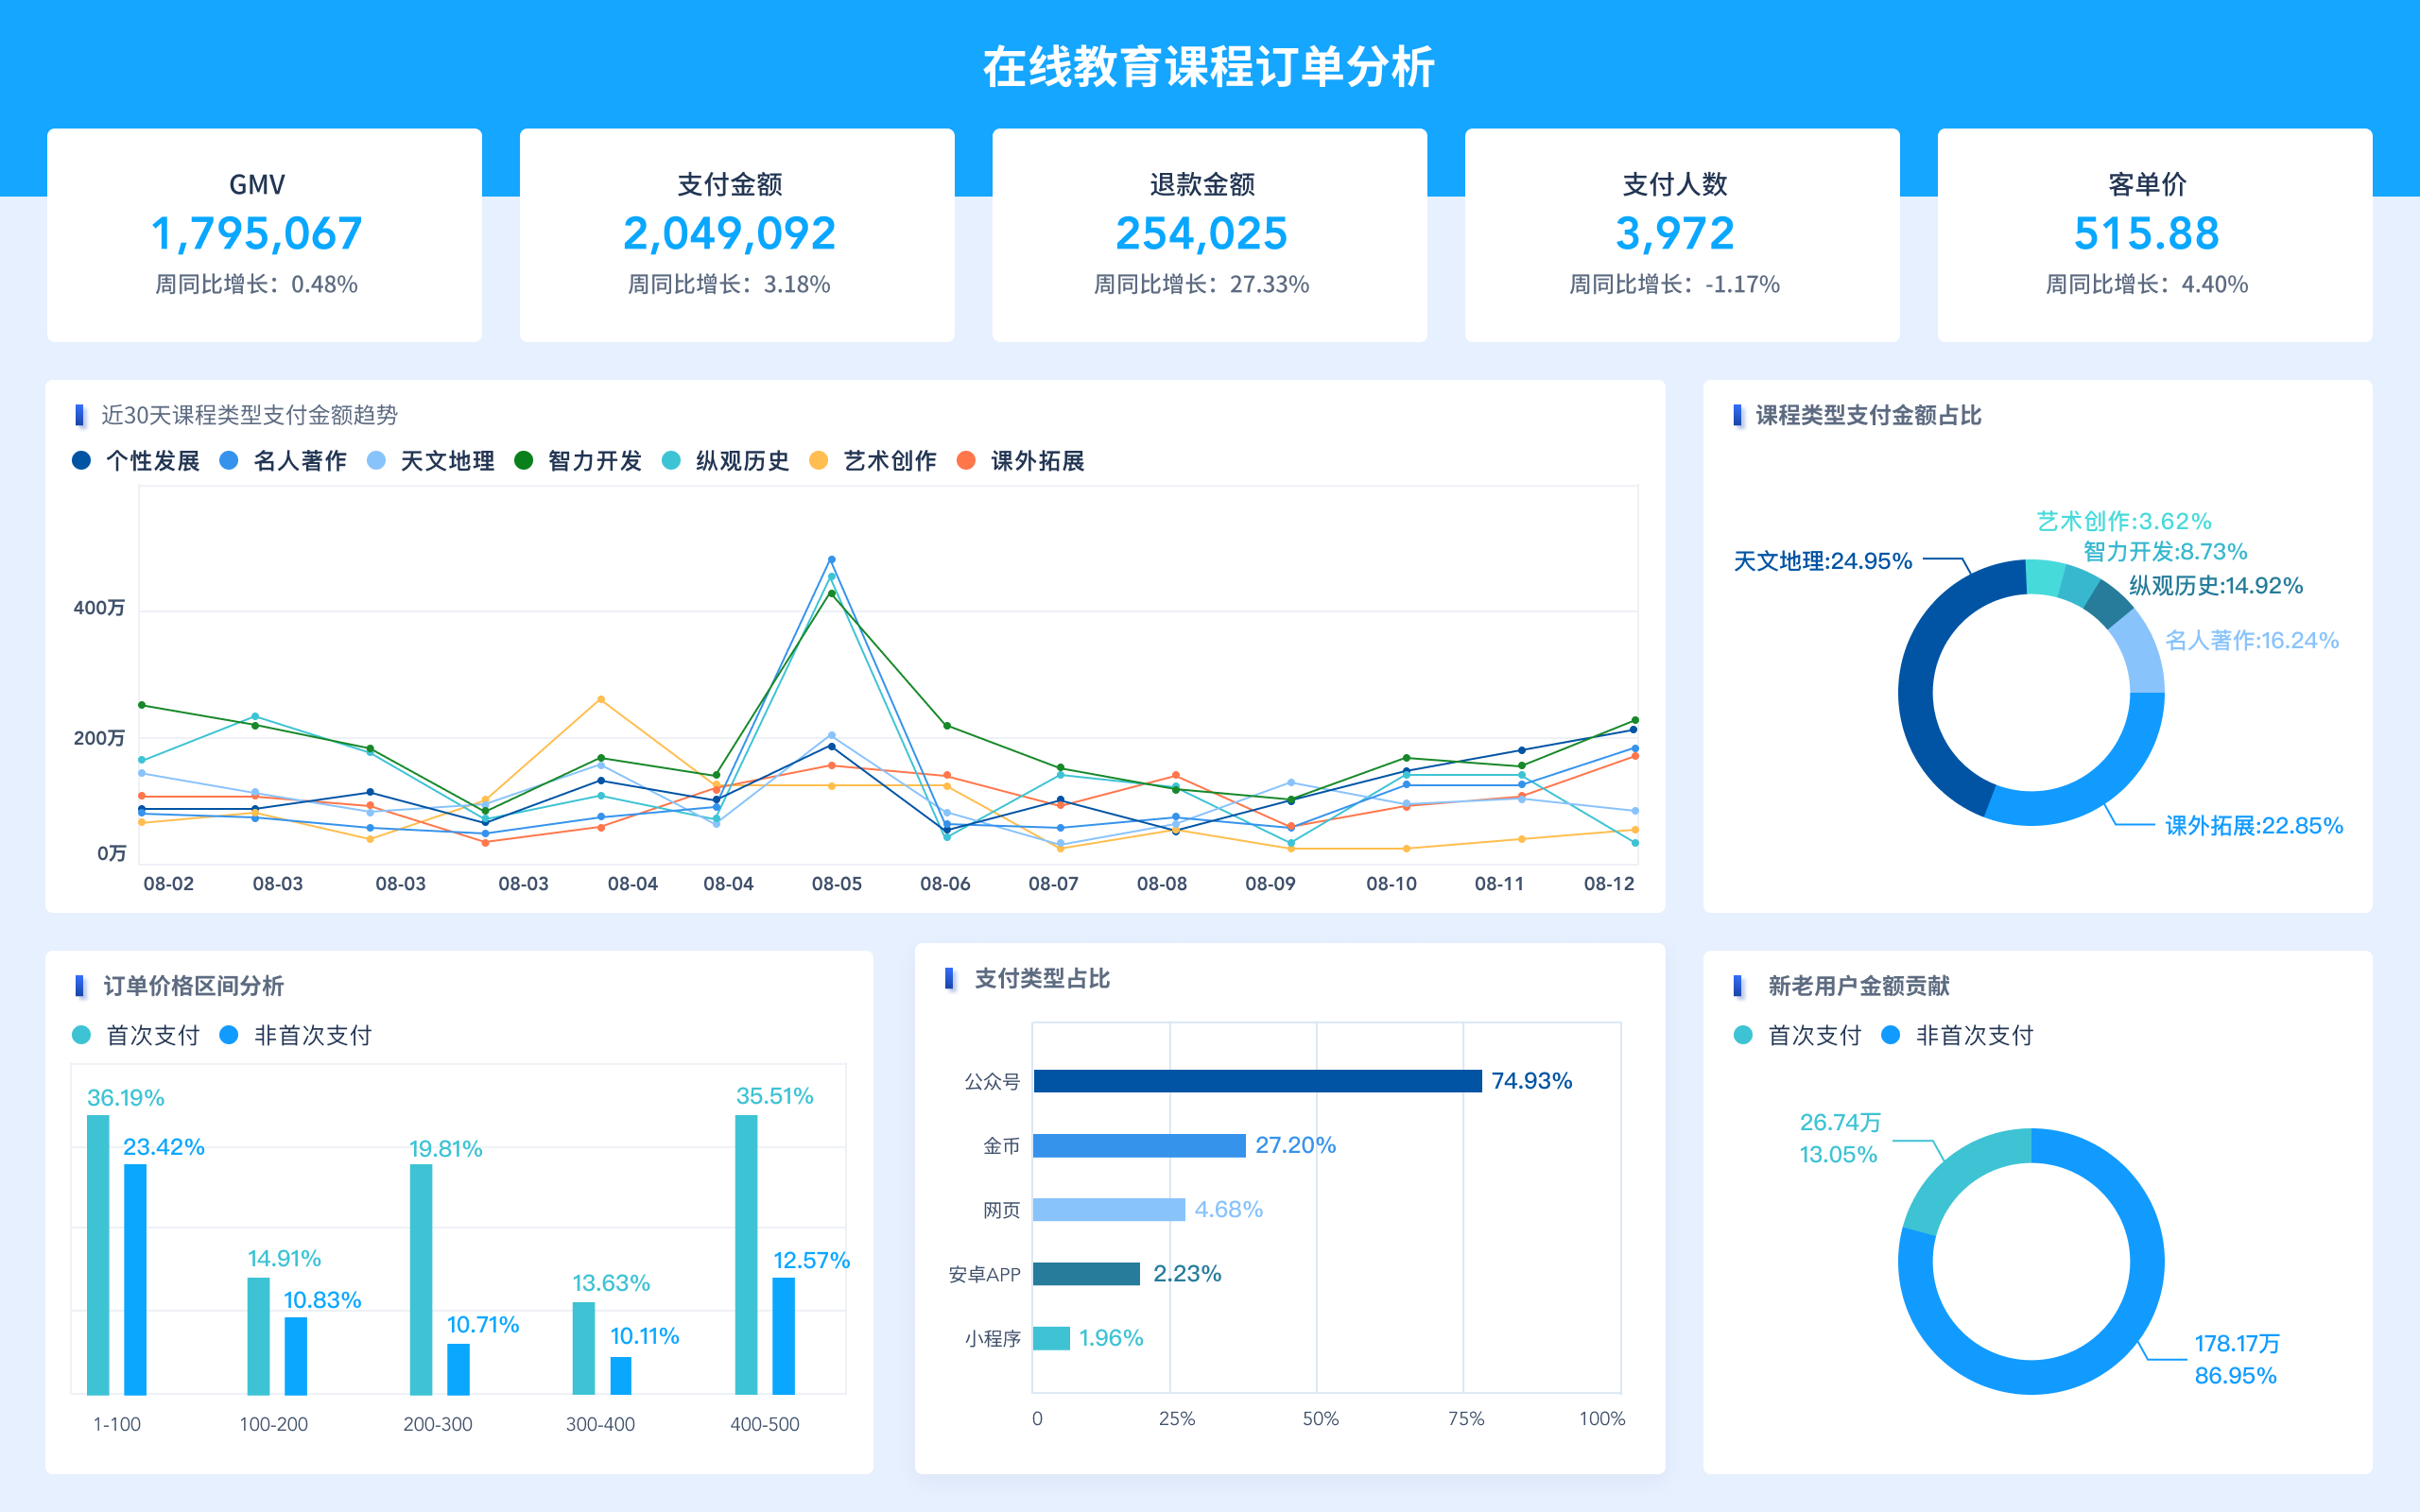
FineBI是帆软旗下的一款强大的数据分析工具,能够帮助用户轻松进行Logistic回归分析。通过FineBI,用户可以快速导入数据、进行可视化分析、构建和评估Logistic回归模型,并且可以生成详细的报告。FineBI的直观界面和丰富的功能使得数据分析更加便捷和高效,特别是在处理复杂的回归分析时表现尤为突出。使用FineBI进行Logistic回归分析,不仅能够提高分析的准确性,还能大幅提升工作效率。
FineBI官网: https://s.fanruan.com/f459r;
五、实际案例分析
在实际应用中,Logistic回归分析常用于预测二分类结果,例如预测某客户是否会购买某产品。假设我们有一组客户数据,包括年龄、收入、是否有孩子等特征。我们可以使用这些特征作为自变量,客户是否购买产品作为因变量,构建Logistic回归模型。通过对模型系数的分析,我们可以了解哪些特征对购买行为有显著影响,并据此进行市场策略调整。通过FineBI,我们可以方便地导入数据、构建模型、进行预测,并生成报告以供决策参考。
六、注意事项和常见问题
在进行Logistic回归分析时,需要注意变量的选择和数据的预处理。自变量不宜过多,以避免多重共线性问题,数据的标准化和缺失值处理也非常重要。多重共线性会导致系数不稳定,从而影响模型的解释能力。可以通过VIF(方差膨胀因子)来检测和处理多重共线性问题。数据的标准化可以使模型更稳定,特别是当自变量取值范围差异较大时。此外,缺失值的处理也需要谨慎,可以通过插值法或删除缺失值较多的样本来解决。
七、扩展阅读和学习资源
为了更深入地理解Logistic回归分析,可以参考一些经典的统计学和机器学习教材,如《The Elements of Statistical Learning》和《Pattern Recognition and Machine Learning》。这些书籍详细介绍了Logistic回归的理论基础和应用案例。此外,在线课程和培训也是学习的好资源,如Coursera和edX上的数据科学课程,以及帆软提供的FineBI培训课程。这些资源可以帮助初学者和专业人士系统地学习和掌握Logistic回归分析。
通过本文的详细介绍,相信大家对Logistic回归分析数据的解读有了更深刻的理解。在数据分析的过程中,选择合适的工具和方法至关重要,FineBI无疑是一个值得推荐的选择。FineBI官网: https://s.fanruan.com/f459r;
相关问答FAQs:
1. 什么是Logistic回归分析?
Logistic回归分析是一种统计方法,用于预测二元结果(例如,是/否、成功/失败等)与一个或多个自变量之间的关系。其核心思想在于,Logistic回归通过构建一个逻辑函数,将输入的自变量映射到0和1之间的概率值。通过这种方式,研究者可以理解自变量如何影响结果变量,并据此进行预测。
在实际应用中,Logistic回归广泛应用于医疗、金融、市场营销等领域。例如,医生可以利用Logistic回归模型来预测患者是否会患上某种疾病,金融分析师可以预测客户是否会违约等。在进行Logistic回归分析时,通常需要处理的数据包括自变量(如年龄、收入、教育水平等)和因变量(如是否患病、是否违约等)。
2. 如何解读Logistic回归分析的结果?
解读Logistic回归分析的结果时,需要关注几个关键指标。首先是回归系数(β值),它们反映了自变量对结果变量的影响程度。每个自变量的回归系数可以通过以下方式理解:当其他变量保持不变时,自变量每增加一个单位,因变量发生变化的对数几率(log-odds)会增加或减少β值的单位。
其次,Odds Ratio(优势比)是Logistic回归分析中一个重要的解读工具。优势比是通过对回归系数进行指数运算得到的,反映了自变量变化对因变量的影响。具体来说,Odds Ratio大于1意味着自变量的增加会增加因变量发生的几率,而小于1则表示相反。例如,如果某个自变量的Odds Ratio为1.5,这表示该变量每增加一个单位,因变量发生的几率将增加50%。
此外,模型的拟合优度(如伪R²值、Hosmer-Lemeshow检验等)也是解读结果的重要部分。伪R²值可以用来评估模型对数据的解释能力,而Hosmer-Lemeshow检验则用于检验模型的适配性。如果模型的拟合优度指标较高,说明该模型能够较好地描述数据中的关系。
3. 在进行Logistic回归分析时需要注意哪些事项?
进行Logistic回归分析时,有几个重要事项需要注意。首先,变量的选择至关重要。自变量的选择应基于理论背景和先前研究的结果,确保所选变量与因变量有合理的关系。如果自变量之间存在多重共线性,可能会影响模型的稳定性和解释性,因此在建模前需要进行相关性分析。
其次,样本量的大小也会影响Logistic回归分析的结果。一般来说,样本量越大,模型的估计越稳定,但也需要注意样本的代表性,确保样本能够真实反映研究对象的特征。
数据预处理同样重要,包括对缺失值的处理、异常值的识别和分类变量的编码。确保数据质量可以提高模型的可靠性。此外,模型的验证也不能忽视,通常通过交叉验证、留出法等方法对模型进行评估,以确保模型的推广能力和准确性。
最后,结果的解释需要谨慎。尽管Logistic回归模型可以提供有价值的见解,但不能简单地将因果关系等同于相关性。研究者应该结合领域知识,综合考虑其他潜在因素对结果的影响,以确保结论的科学性和可靠性。
本文内容通过AI工具匹配关键字智能整合而成,仅供参考,帆软不对内容的真实、准确或完整作任何形式的承诺。具体产品功能请以帆软官方帮助文档为准,或联系您的对接销售进行咨询。如有其他问题,您可以通过联系blog@fanruan.com进行反馈,帆软收到您的反馈后将及时答复和处理。