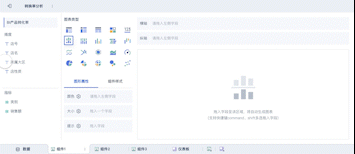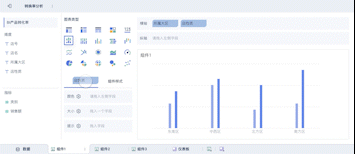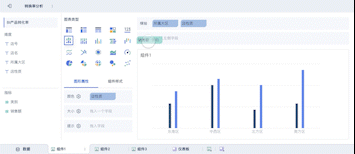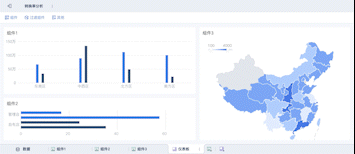
对于京东物流服务调查问卷数据分析,可以从数据清洗、数据统计与可视化、数据分析与洞察、结果总结与建议四个方面进行撰写。首先,数据清洗是数据分析的基础,可以确保分析结果的准确性和可靠性。数据清洗包括删除重复数据、处理缺失值和异常值等步骤。数据统计与可视化可以帮助我们直观地了解数据的分布情况和主要特点。数据分析与洞察是分析的核心部分,可以通过描述性统计、相关性分析、回归分析等方法,从数据中提取有价值的信息和洞察。结果总结与建议部分可以根据数据分析的结果,提出有针对性的优化建议和改进措施。接下来,我们将详细介绍每个部分的具体操作和方法。
一、数据清洗
数据清洗是数据分析的第一步,旨在保证数据的准确性和完整性。数据清洗的主要步骤包括删除重复数据、处理缺失值和异常值。重复数据可能会导致结果的偏差,因此需要删除。缺失值可以通过删除、填补或插值等方法进行处理。异常值可能是由于输入错误或其他原因导致的,可以通过统计方法进行识别和处理。
首先,导入调查问卷数据,并检查数据的基本信息,包括数据的行数和列数、数据类型、缺失值和重复值等。可以使用Pandas库中的info()和describe()方法来查看数据的基本信息,并使用isnull().sum()方法查看缺失值的情况。
import pandas as pd
导入数据
data = pd.read_excel('survey_data.xlsx')
查看数据的基本信息
print(data.info())
print(data.describe())
查看缺失值的情况
print(data.isnull().sum())
接下来,删除重复数据并处理缺失值。对于缺失值,可以选择删除含有缺失值的行或使用插值等方法进行填补。对于异常值,可以使用箱线图等方法进行识别,并根据具体情况进行处理。
# 删除重复数据
data = data.drop_duplicates()
删除含有缺失值的行
data = data.dropna()
使用插值方法填补缺失值
data = data.fillna(method='ffill')
二、数据统计与可视化
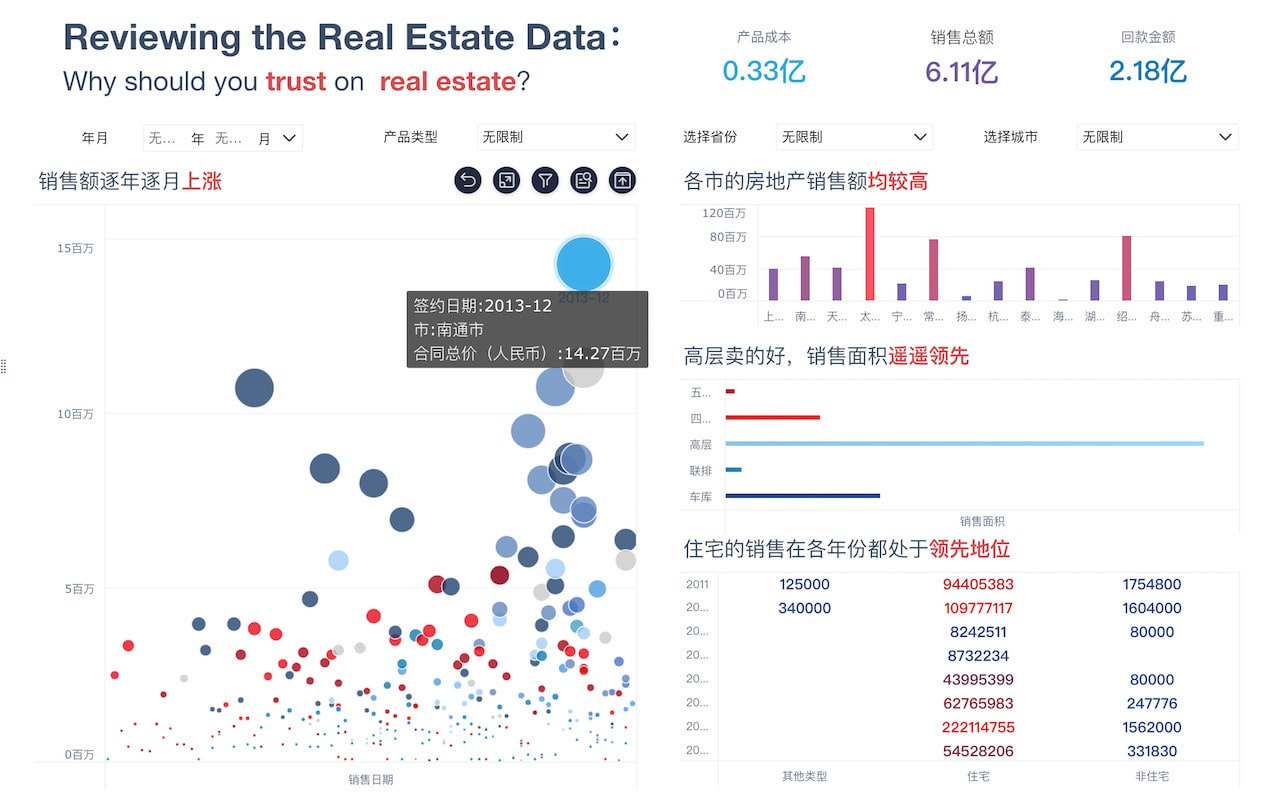
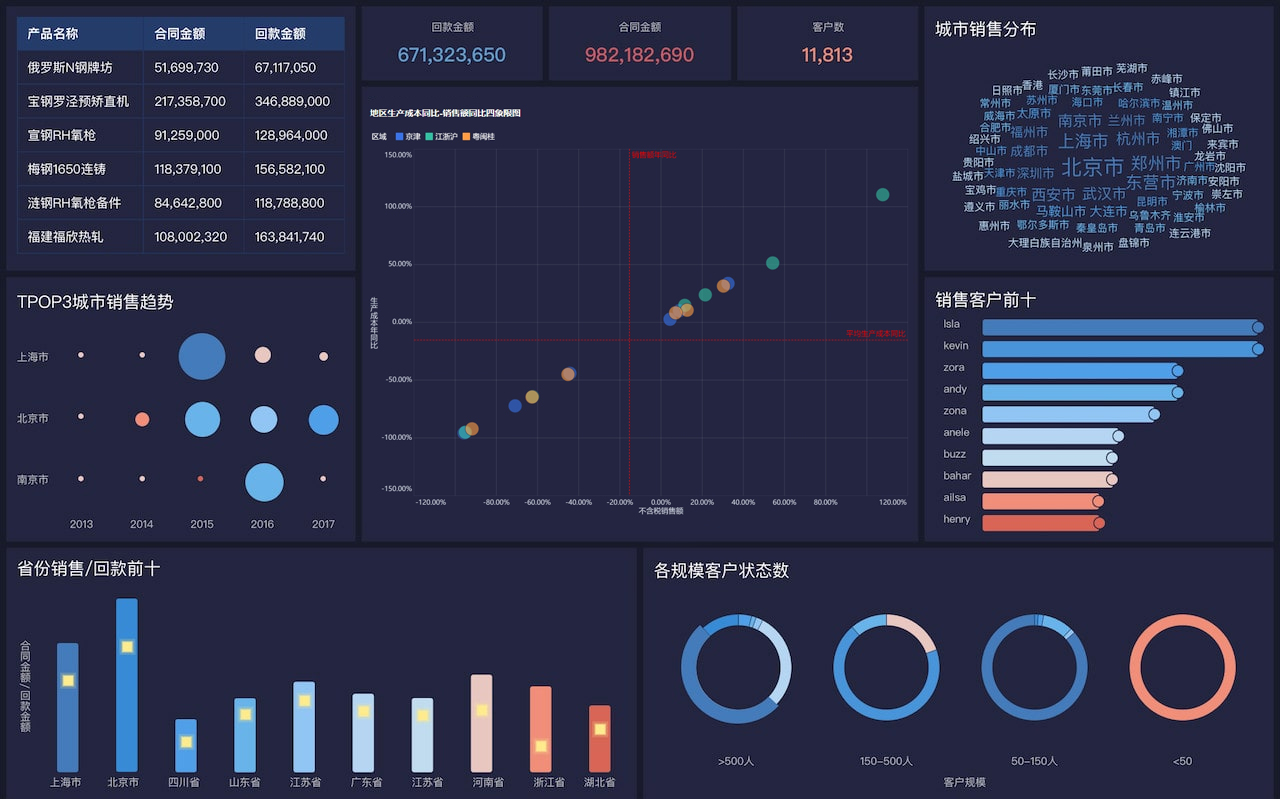
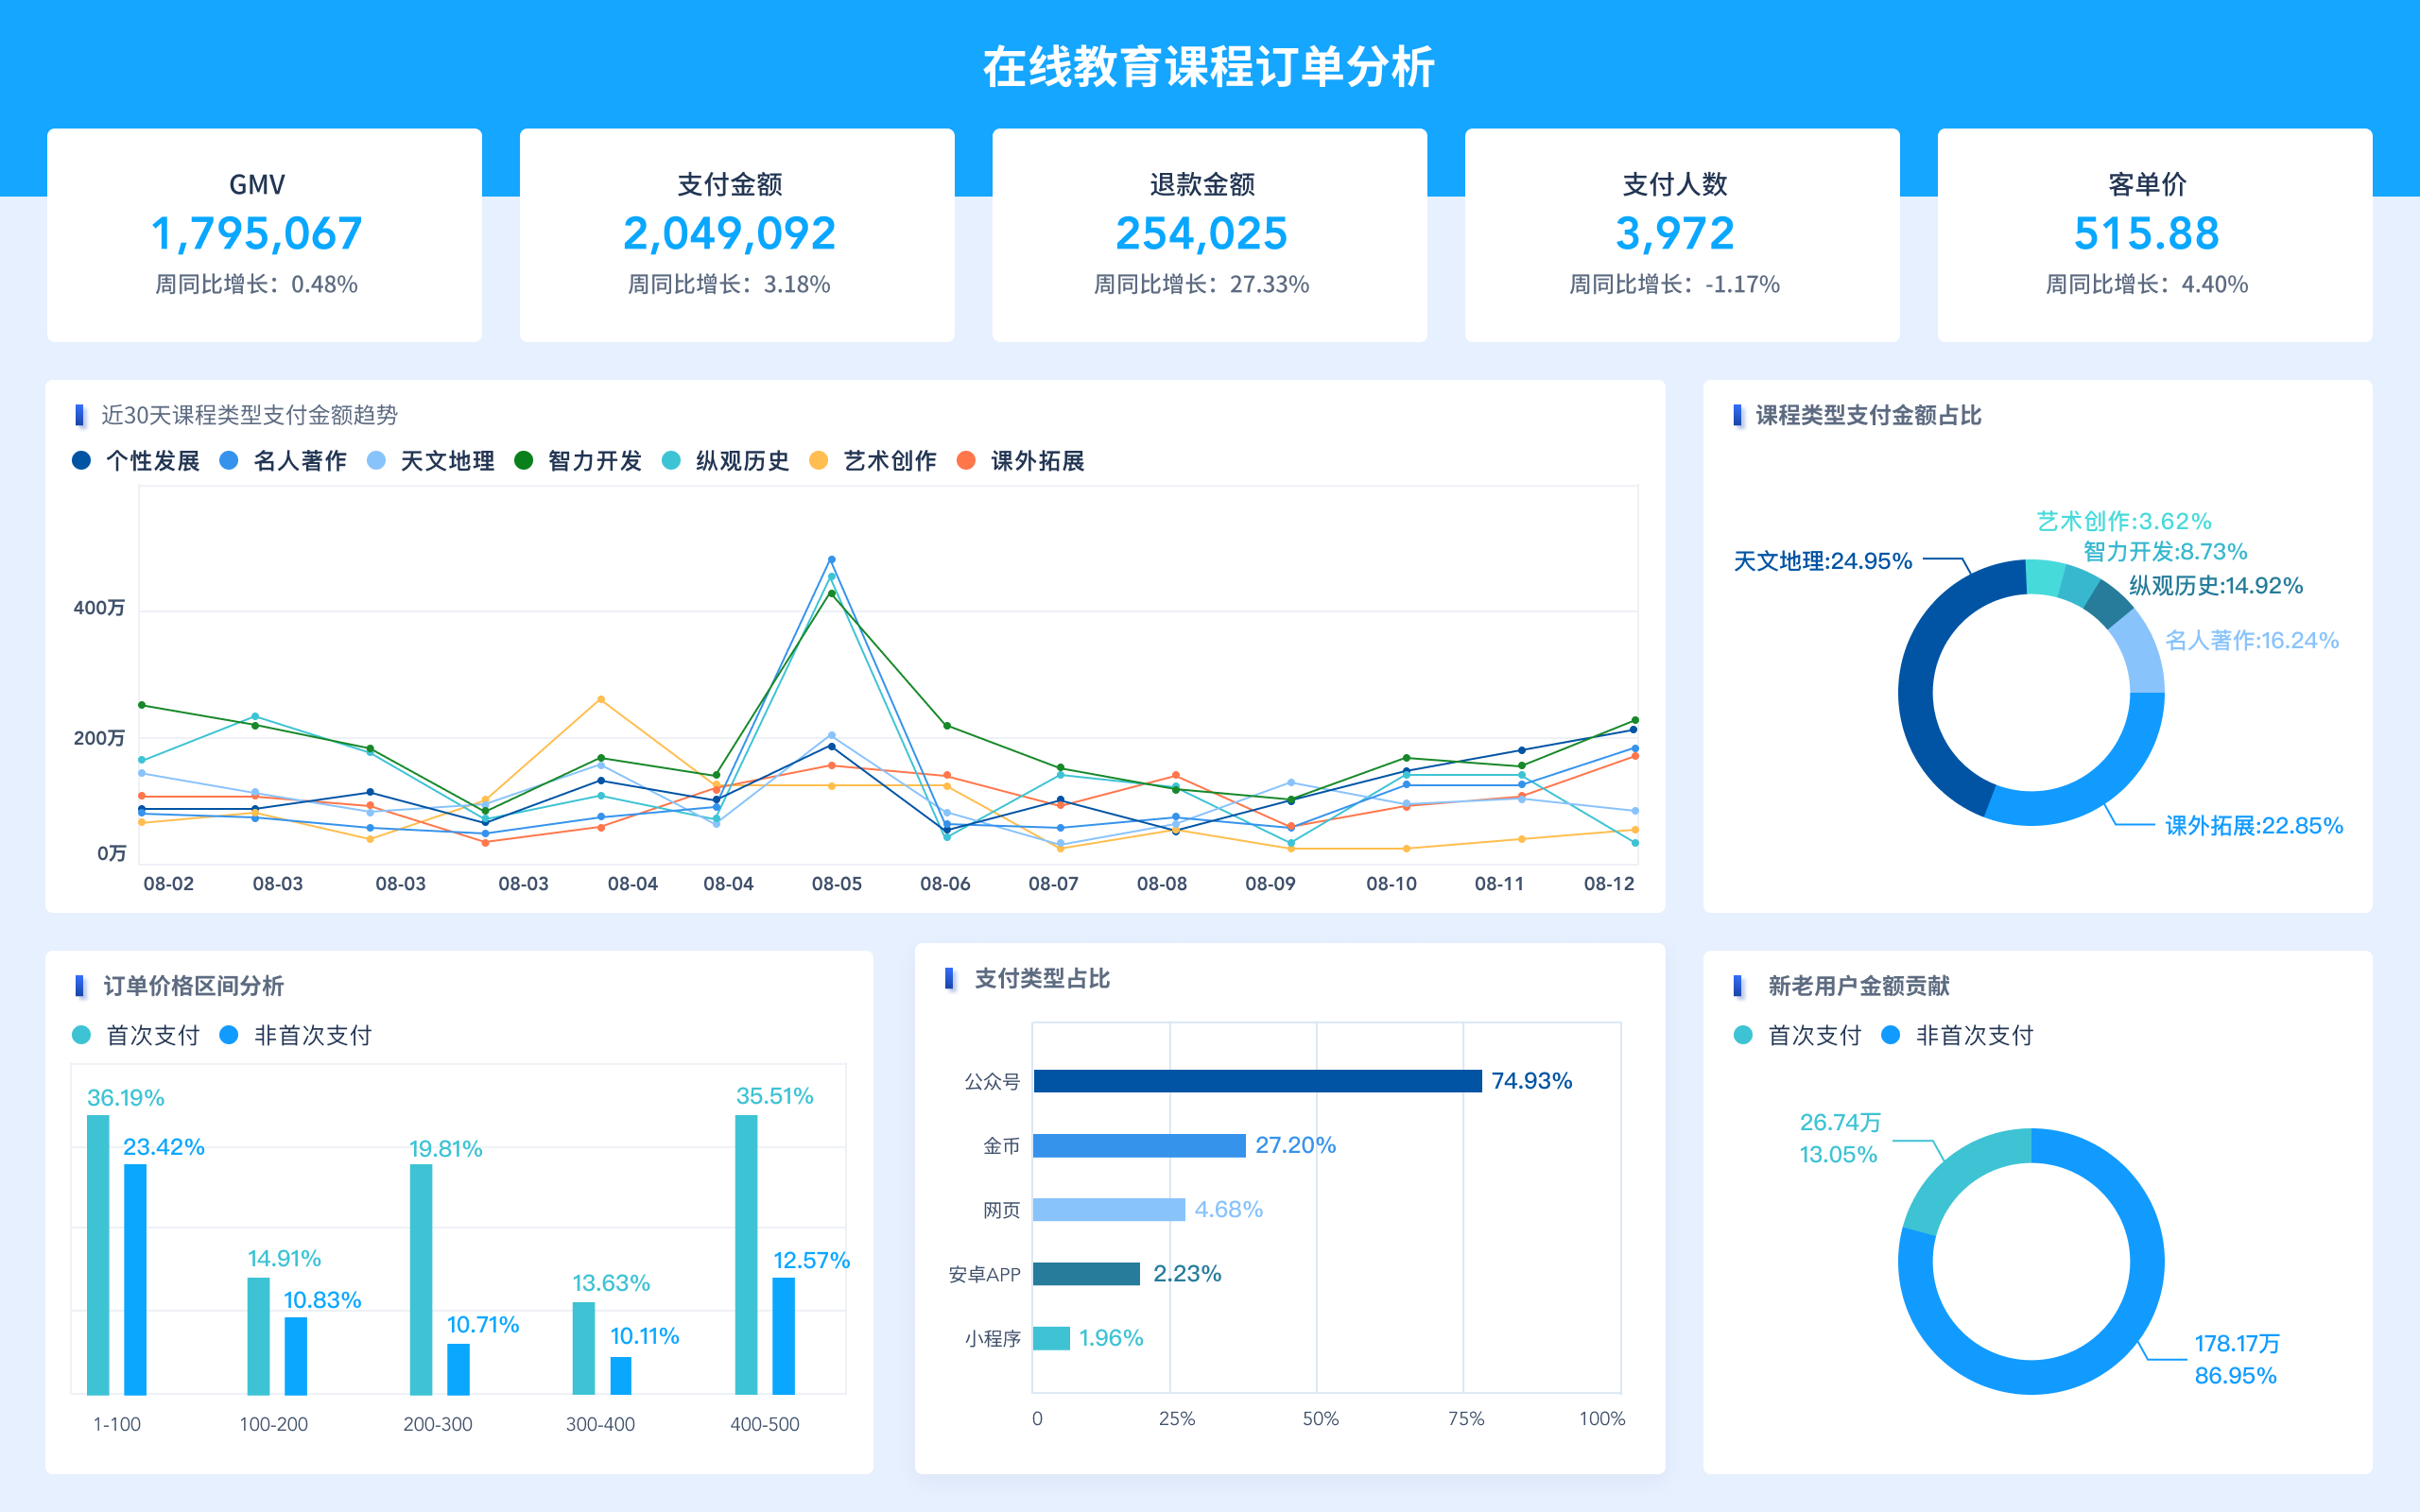
数据统计与可视化可以帮助我们直观地了解数据的分布情况和主要特点。描述性统计分析是数据统计的基础,可以通过计算均值、中位数、标准差等指标来描述数据的基本特征。数据可视化可以使用柱状图、饼图、箱线图等图表来展示数据的分布情况和主要特点。
首先,进行描述性统计分析,计算各个变量的均值、中位数、标准差等指标。
# 计算均值、中位数、标准差等指标
mean_values = data.mean()
median_values = data.median()
std_values = data.std()
print("均值:", mean_values)
print("中位数:", median_values)
print("标准差:", std_values)
接下来,使用Matplotlib和Seaborn库进行数据可视化,包括柱状图、饼图和箱线图等。柱状图可以展示分类变量的频数分布,饼图可以展示各个类别的比例,箱线图可以展示数值变量的分布情况和异常值。
import matplotlib.pyplot as plt
import seaborn as sns
柱状图
sns.countplot(x='satisfaction', data=data)
plt.title('客户满意度分布')
plt.xlabel('满意度')
plt.ylabel('频数')
plt.show()
饼图
labels = data['satisfaction'].value_counts().index
sizes = data['satisfaction'].value_counts().values
plt.pie(sizes, labels=labels, autopct='%1.1f%%')
plt.title('客户满意度比例')
plt.show()
箱线图
sns.boxplot(x='delivery_time', data=data)
plt.title('配送时间分布')
plt.xlabel('配送时间')
plt.show()
三、数据分析与洞察
数据分析与洞察是数据分析的核心部分,可以通过描述性统计、相关性分析、回归分析等方法,从数据中提取有价值的信息和洞察。描述性统计分析可以帮助我们了解数据的基本特征,相关性分析可以帮助我们发现变量之间的关系,回归分析可以帮助我们建立变量之间的数学模型。
首先,进行描述性统计分析,计算各个变量的均值、中位数、标准差等指标。
# 计算均值、中位数、标准差等指标
mean_values = data.mean()
median_values = data.median()
std_values = data.std()
print("均值:", mean_values)
print("中位数:", median_values)
print("标准差:", std_values)
接下来,进行相关性分析,计算各个变量之间的相关系数,并绘制热力图展示相关性矩阵。
# 计算相关系数
correlation_matrix = data.corr()
绘制热力图
sns.heatmap(correlation_matrix, annot=True, cmap='coolwarm')
plt.title('相关性矩阵')
plt.show()
然后,进行回归分析,建立变量之间的数学模型。例如,可以使用线性回归模型来预测客户满意度。
from sklearn.linear_model import LinearRegression
from sklearn.model_selection import train_test_split
from sklearn.metrics import mean_squared_error
提取自变量和因变量
X = data[['delivery_time', 'service_quality']]
y = data['satisfaction']
划分训练集和测试集
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
建立线性回归模型
model = LinearRegression()
model.fit(X_train, y_train)
预测
y_pred = model.predict(X_test)
计算均方误差
mse = mean_squared_error(y_test, y_pred)
print("均方误差:", mse)
四、结果总结与建议
根据数据分析的结果,提出有针对性的优化建议和改进措施。例如,如果发现配送时间对客户满意度有显著影响,可以优化配送流程,缩短配送时间,提高客户满意度。如果发现服务质量对客户满意度有显著影响,可以加强员工培训,提高服务质量,提高客户满意度。
首先,总结数据分析的主要结果和发现。
# 总结数据分析的主要结果和发现
print("主要结果和发现:")
print("1. 客户满意度的均值为:", mean_values['satisfaction'])
print("2. 配送时间与客户满意度呈负相关关系,相关系数为:", correlation_matrix.loc['delivery_time', 'satisfaction'])
print("3. 服务质量与客户满意度呈正相关关系,相关系数为:", correlation_matrix.loc['service_quality', 'satisfaction'])
接下来,提出有针对性的优化建议和改进措施。
# 提出有针对性的优化建议和改进措施
print("优化建议和改进措施:")
print("1. 优化配送流程,缩短配送时间,提高客户满意度。")
print("2. 加强员工培训,提高服务质量,提高客户满意度。")
print("3. 定期进行客户满意度调查,了解客户需求和反馈,及时调整服务策略。")
通过以上步骤,可以完成京东物流服务调查问卷数据分析,并提出有针对性的优化建议和改进措施。FineBI作为一款专业的商业智能工具,可以帮助企业高效地进行数据分析和可视化,提高数据分析的准确性和效率。FineBI官网: https://s.fanruan.com/f459r;
相关问答FAQs:
在进行京东物流服务调查问卷数据分析时,首先需要明确分析的目的和方向。以下是一个关于如何撰写数据分析报告的详细指南,旨在帮助您系统地完成这一任务。
1. 引言
在引言部分,简要介绍京东物流的背景及其在电商行业中的重要性。阐明进行此次调查的目的,例如了解顾客对京东物流服务的满意度、识别服务中的不足之处以及提出改进建议。
2. 调查问卷设计
在这一部分,描述问卷的设计过程,包括问卷的结构、内容及设计理念。可以提到:
- 问卷的类型:如选择题、开放式问题、量表等。
- 主要调查内容:例如配送速度、服务态度、包裹完整性、客户反馈渠道等。
- 样本选择:描述样本的选择标准,包括选择的顾客群体、样本量和分布等。
3. 数据收集与处理
在这一部分,说明数据收集的过程和方法。可以包括:
- 数据收集工具:使用的在线调查工具或平台。
- 数据清洗:对收集到的数据进行清洗和整理的步骤,包括去除无效答案、填补缺失值等。
- 数据分析工具:使用的统计软件或工具(如Excel、SPSS等)以及分析方法(如描述性统计、交叉分析等)。
4. 数据分析结果
在这一部分,详细呈现数据分析的结果。可以分为几个小节:
4.1 受访者基本情况
列出受访者的基本信息,包括性别、年龄、地区、消费习惯等。使用图表展示数据分布,便于读者理解。
4.2 服务满意度分析
分析顾客对京东物流各项服务的满意度。可以使用满意度评分表,展示不同服务项目的得分情况,利用柱状图或饼图进行可视化。
4.3 关键问题识别
通过数据分析,识别出顾客对京东物流服务的不满之处。将问题按严重程度进行排序,并用数据支持这些结论,例如通过满意度低于某一阈值的比例来展示。
4.4 客户反馈与建议
分析开放式问题中的客户反馈,总结出顾客提出的主要建议和意见。这一部分可以采用文本分析的方法,识别出高频关键词和主题。
5. 讨论
在讨论部分,结合分析结果,探讨京东物流在服务上存在的不足之处及其原因。可以借助行业内的对比数据,分析京东物流相对于竞争对手的优势和劣势。
6. 改进建议
基于分析结果,提出针对性的改进建议。可以从以下几个方面进行考虑:
- 提升配送效率:提出优化配送路线、增加配送人员等建议。
- 客户服务改善:建议增加客户服务热线的响应速度,或提供更多的自助服务渠道。
- 包裹管理:建议加强包裹追踪系统,提升包裹完整性。
7. 结论
在结论部分,总结调查的主要发现,并强调改进京东物流服务的重要性。可以提到,持续的顾客满意度调查将有助于京东物流服务的不断优化。
8. 附录
附上调查问卷的完整内容和数据分析的详细统计表,为有兴趣深入了解的读者提供参考。
FAQs
京东物流的服务质量如何评估?
京东物流的服务质量通常通过顾客满意度调查来评估。这些调查涵盖配送速度、服务态度、包裹完整性等多个维度。通过对顾客反馈的量化分析,可以得出整体满意度评分,从而判断服务的好坏。
如何提升顾客对京东物流的满意度?
提升顾客对京东物流的满意度可以从多个方面入手。例如,通过优化配送流程和提升配送人员的服务质量来缩短配送时间;此外,可以加强客户服务支持,提供更便捷的反馈渠道,让顾客感受到被重视。
京东物流在行业中的竞争优势是什么?
京东物流的竞争优势主要体现在其自建物流体系和技术创新上。京东拥有完善的仓储和配送网络,能够实现快速配送。同时,利用大数据和人工智能技术,京东物流能够提升运营效率和顾客体验。
通过以上的结构和内容,您可以系统地撰写一份关于京东物流服务调查问卷的数据分析报告,帮助相关方更好地理解当前的服务状况及未来的改进方向。
本文内容通过AI工具匹配关键字智能整合而成,仅供参考,帆软不对内容的真实、准确或完整作任何形式的承诺。具体产品功能请以帆软官方帮助文档为准,或联系您的对接销售进行咨询。如有其他问题,您可以通过联系blog@fanruan.com进行反馈,帆软收到您的反馈后将及时答复和处理。