在进行手术后重复测量数据分析时,可以使用混合效应模型、重复测量方差分析、线性回归模型等方法。混合效应模型是一种常见且有效的方法,因为它能够处理数据中的个体差异。混合效应模型不仅考虑了固定效应,还考虑了随机效应,这使得它可以更好地处理重复测量数据中的相关性和个体间的差异。通过混合效应模型,我们可以得到更准确的参数估计和更可靠的统计推断。
一、混合效应模型
混合效应模型是分析重复测量数据的一个强大工具。它可以处理数据中的个体间差异,并且可以有效地处理缺失数据。混合效应模型分为固定效应和随机效应两部分,固定效应描述的是总体的平均效应,而随机效应描述的是个体差异。通过混合效应模型,可以识别出哪些因素对手术后的重复测量数据有显著影响。在使用混合效应模型时,通常需要选择合适的随机效应结构和协方差结构,以便更好地拟合数据并解释结果。
二、重复测量方差分析
重复测量方差分析(Repeated Measures ANOVA)是分析手术后重复测量数据的一种经典方法。它主要用于比较不同时间点或不同处理条件下的均值差异。重复测量方差分析考虑了时间因素和个体差异对数据的影响,因此可以提供更为准确的结果。在进行重复测量方差分析时,需要注意数据的正态性和方差齐性假设。如果数据不满足这些假设,可以考虑进行数据转换或使用非参数方法。
三、线性回归模型
线性回归模型也是分析手术后重复测量数据的一种常见方法。它可以用来研究自变量与因变量之间的线性关系。在重复测量数据中,可以使用多重线性回归模型,考虑时间点、个体差异以及其他可能的影响因素。通过回归分析,可以得到各个自变量对因变量的影响程度,并且可以进行预测和解释。在使用线性回归模型时,需要注意多重共线性问题,并且需要对模型进行诊断和验证。
四、广义估计方程(GEE)
广义估计方程(Generalized Estimating Equations,GEE)是一种处理重复测量数据的非参数方法。它不需要对数据的分布作出严格的假设,因此在处理非正态分布数据时具有优势。GEE可以处理不同类型的因变量(如二元变量、计数变量等),并且可以考虑时间相关性和个体差异。通过GEE,可以得到稳健的参数估计和显著性检验结果。在使用GEE时,需要选择合适的工作相关结构,并进行模型诊断和评估。
五、回归树和随机森林
回归树和随机森林是分析手术后重复测量数据的另一种方法。回归树通过递归划分数据集,构建一棵决策树,从而进行预测和分类。随机森林是多棵回归树的集成,通过投票机制得到最终的预测结果。回归树和随机森林具有较强的解释能力和鲁棒性,可以处理高维数据和复杂的非线性关系。在使用回归树和随机森林时,需要注意模型的过拟合问题,并进行交叉验证和模型选择。
六、数据预处理和可视化
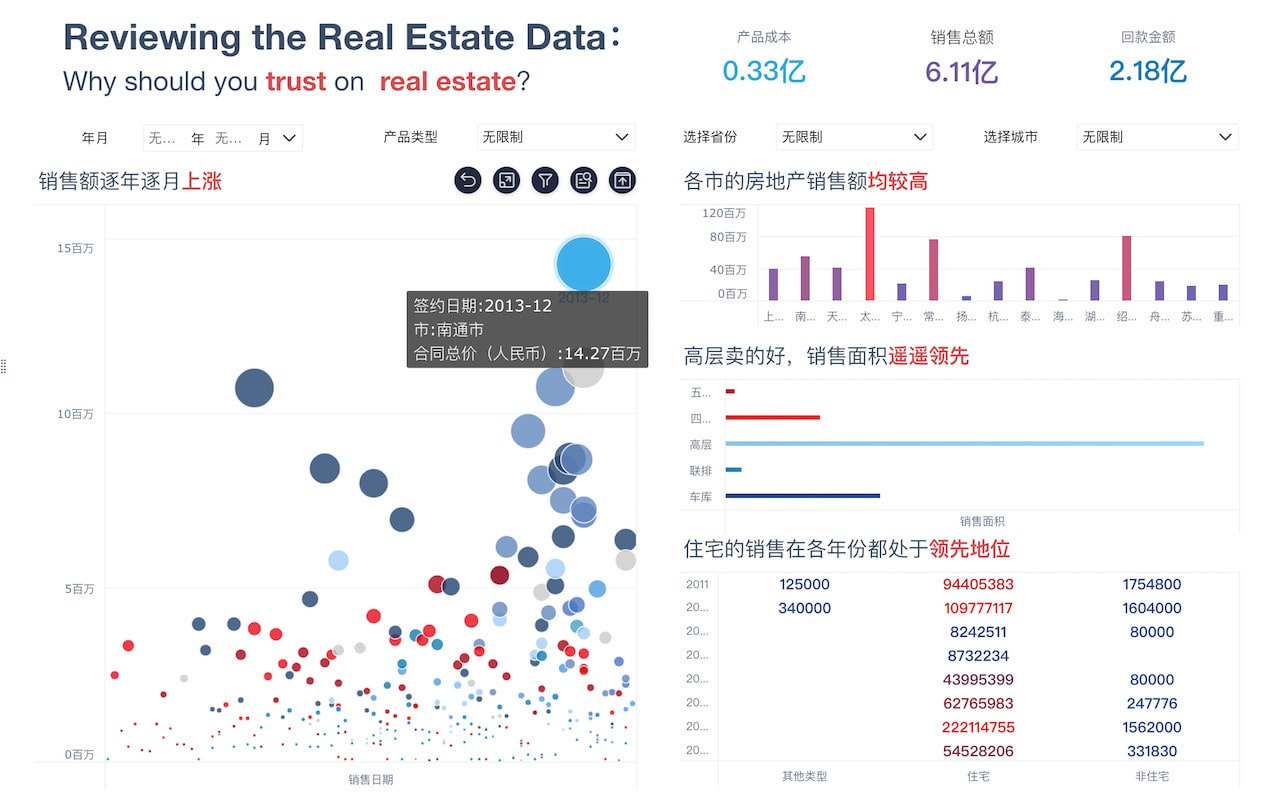
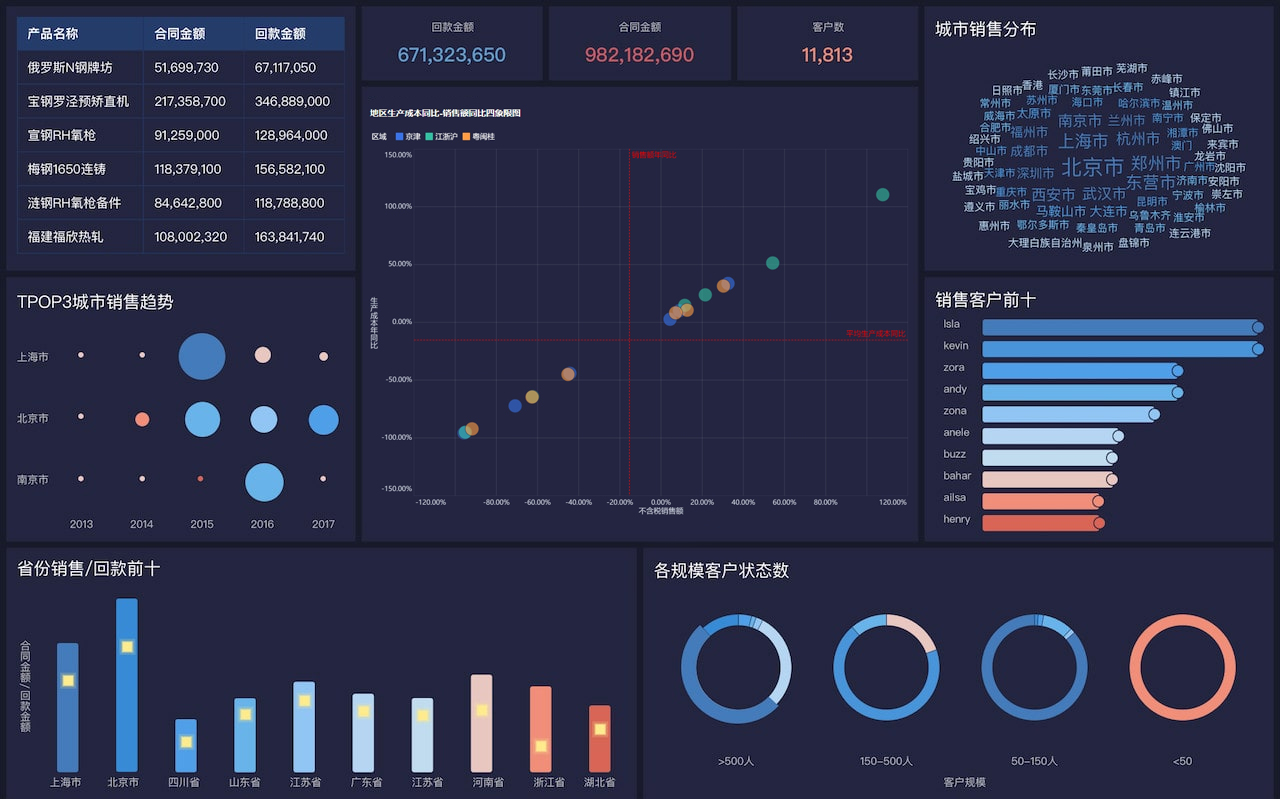
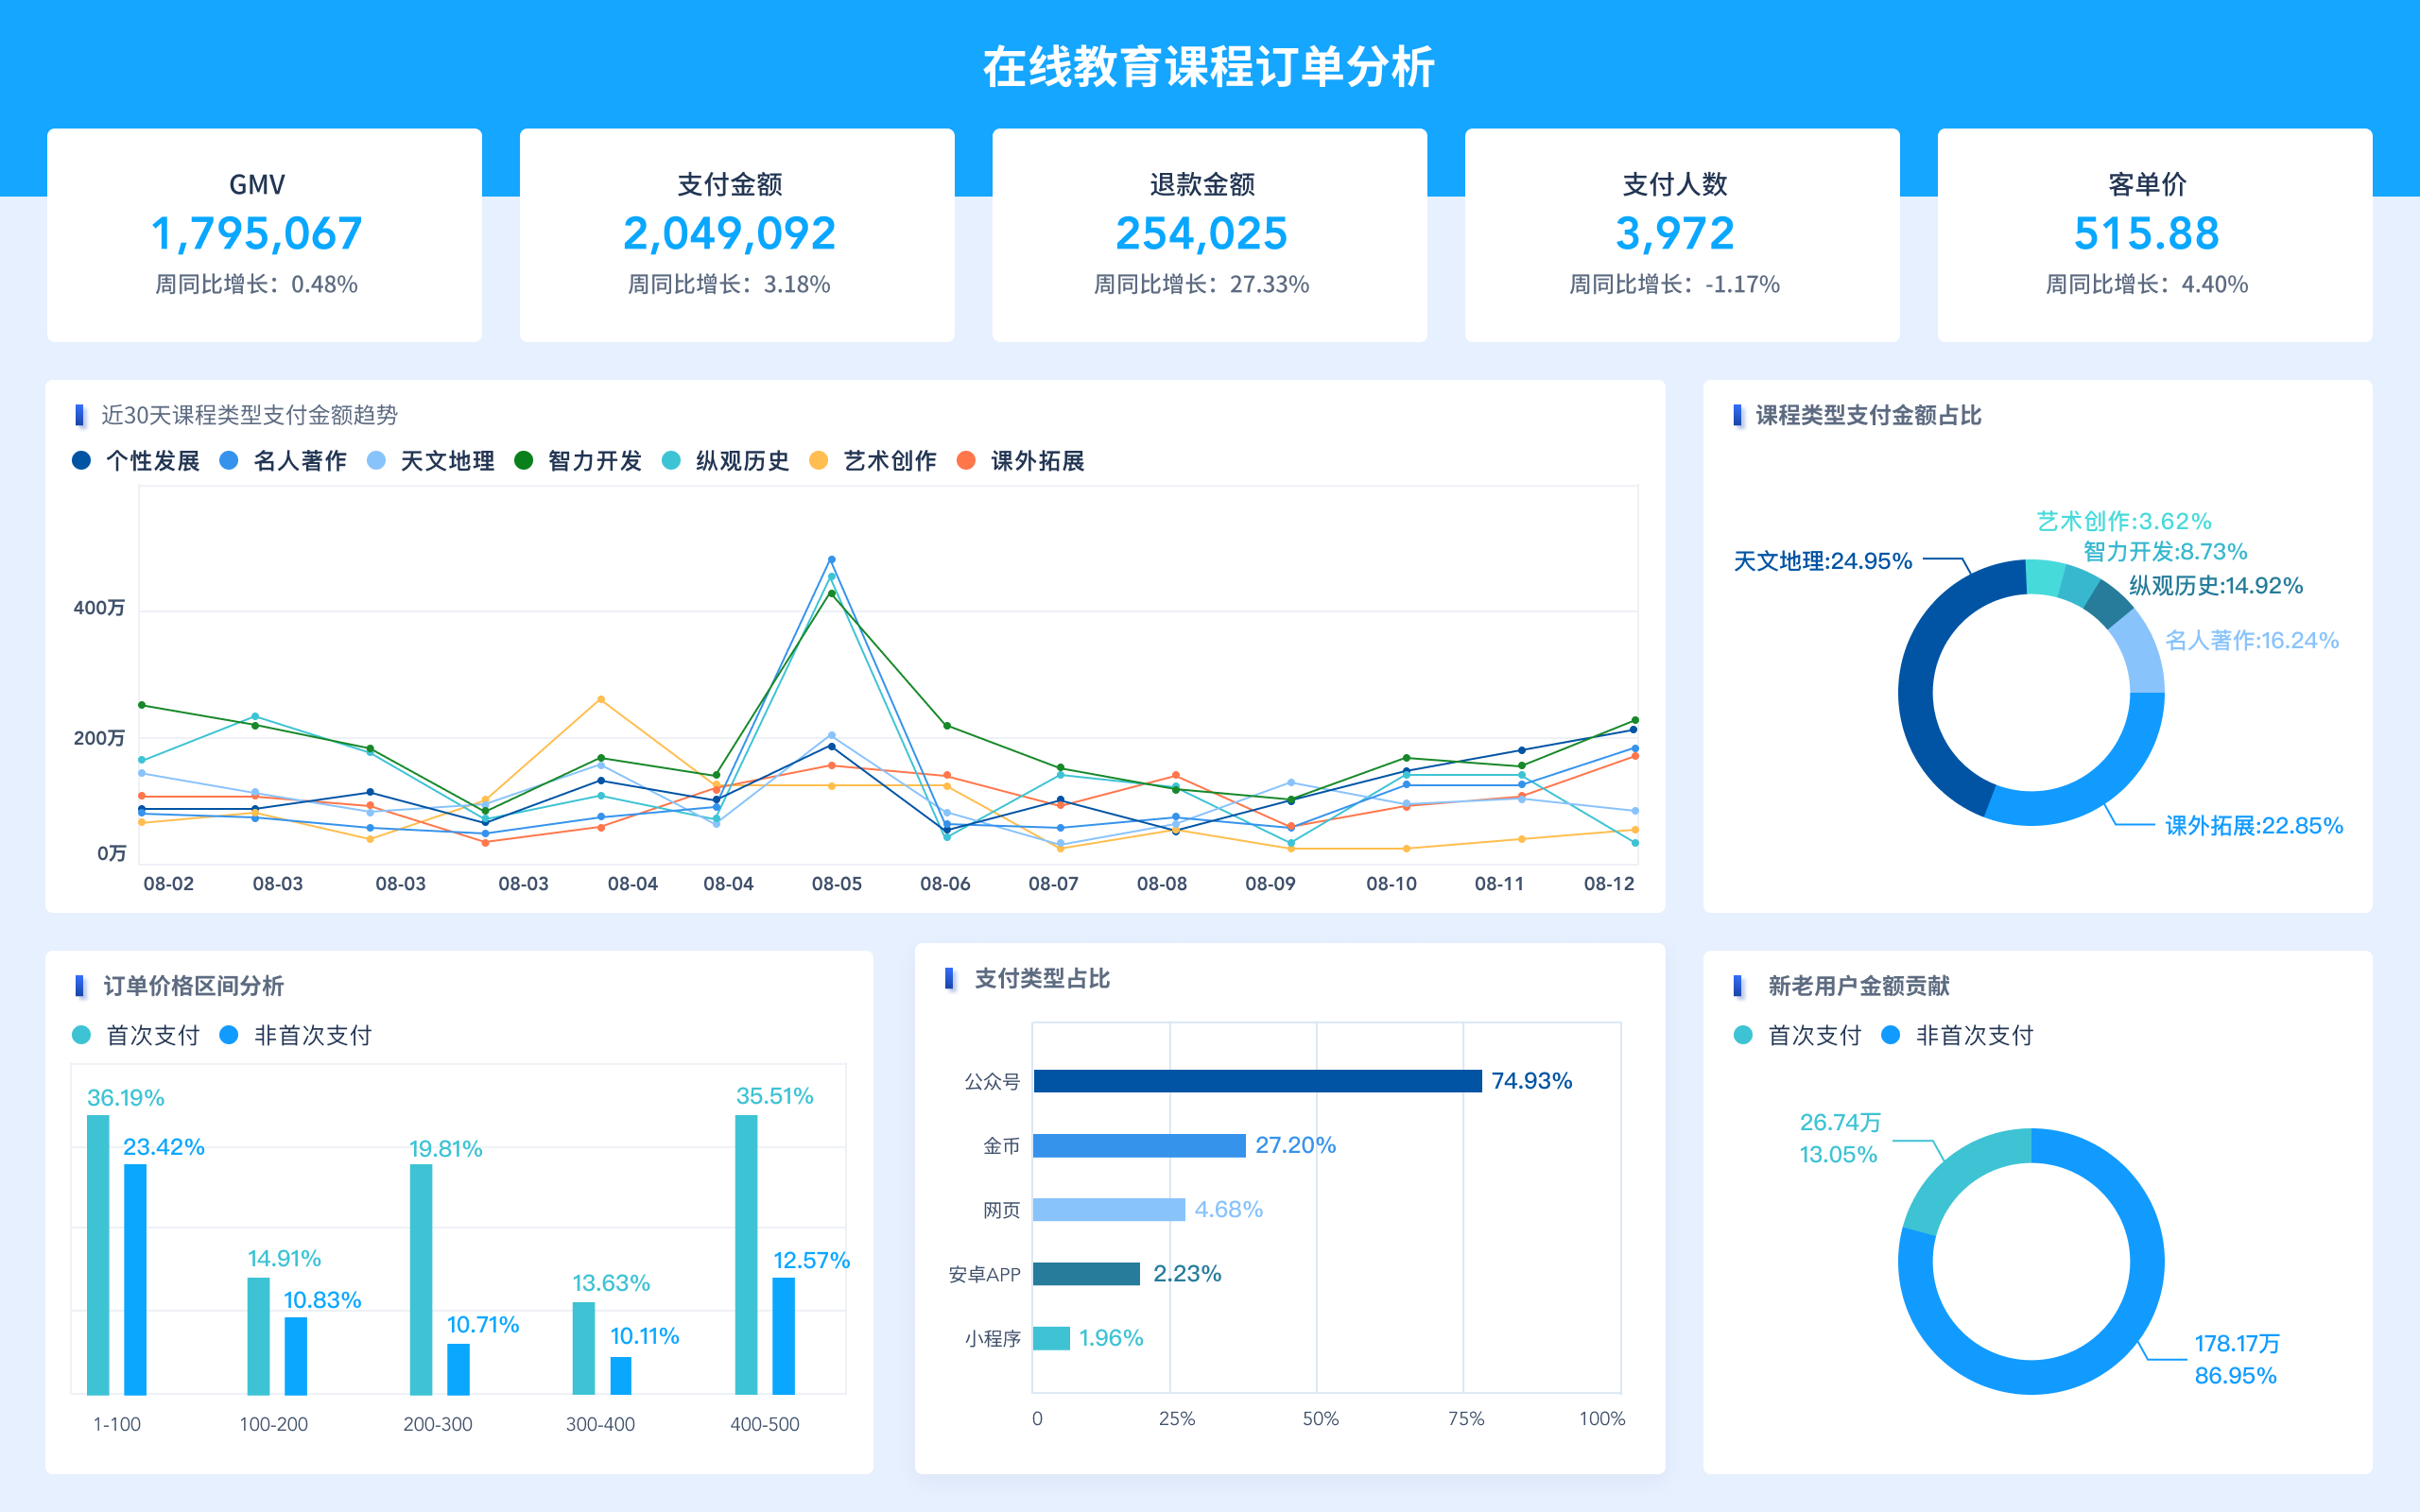
在进行手术后重复测量数据分析之前,数据预处理和可视化是非常重要的步骤。数据预处理包括数据清洗、缺失值处理、变量转换等。通过数据清洗,可以去除异常值和噪声,保证数据的质量。缺失值处理可以采用插值法、删除法等方法,保证数据的完整性。变量转换可以进行数据标准化、对数转换等,以满足模型的假设。数据可视化可以通过绘制时序图、箱线图、散点图等,直观地展示数据的分布和变化趋势,帮助理解数据特征和模式。
七、FineBI与手术后重复测量数据分析
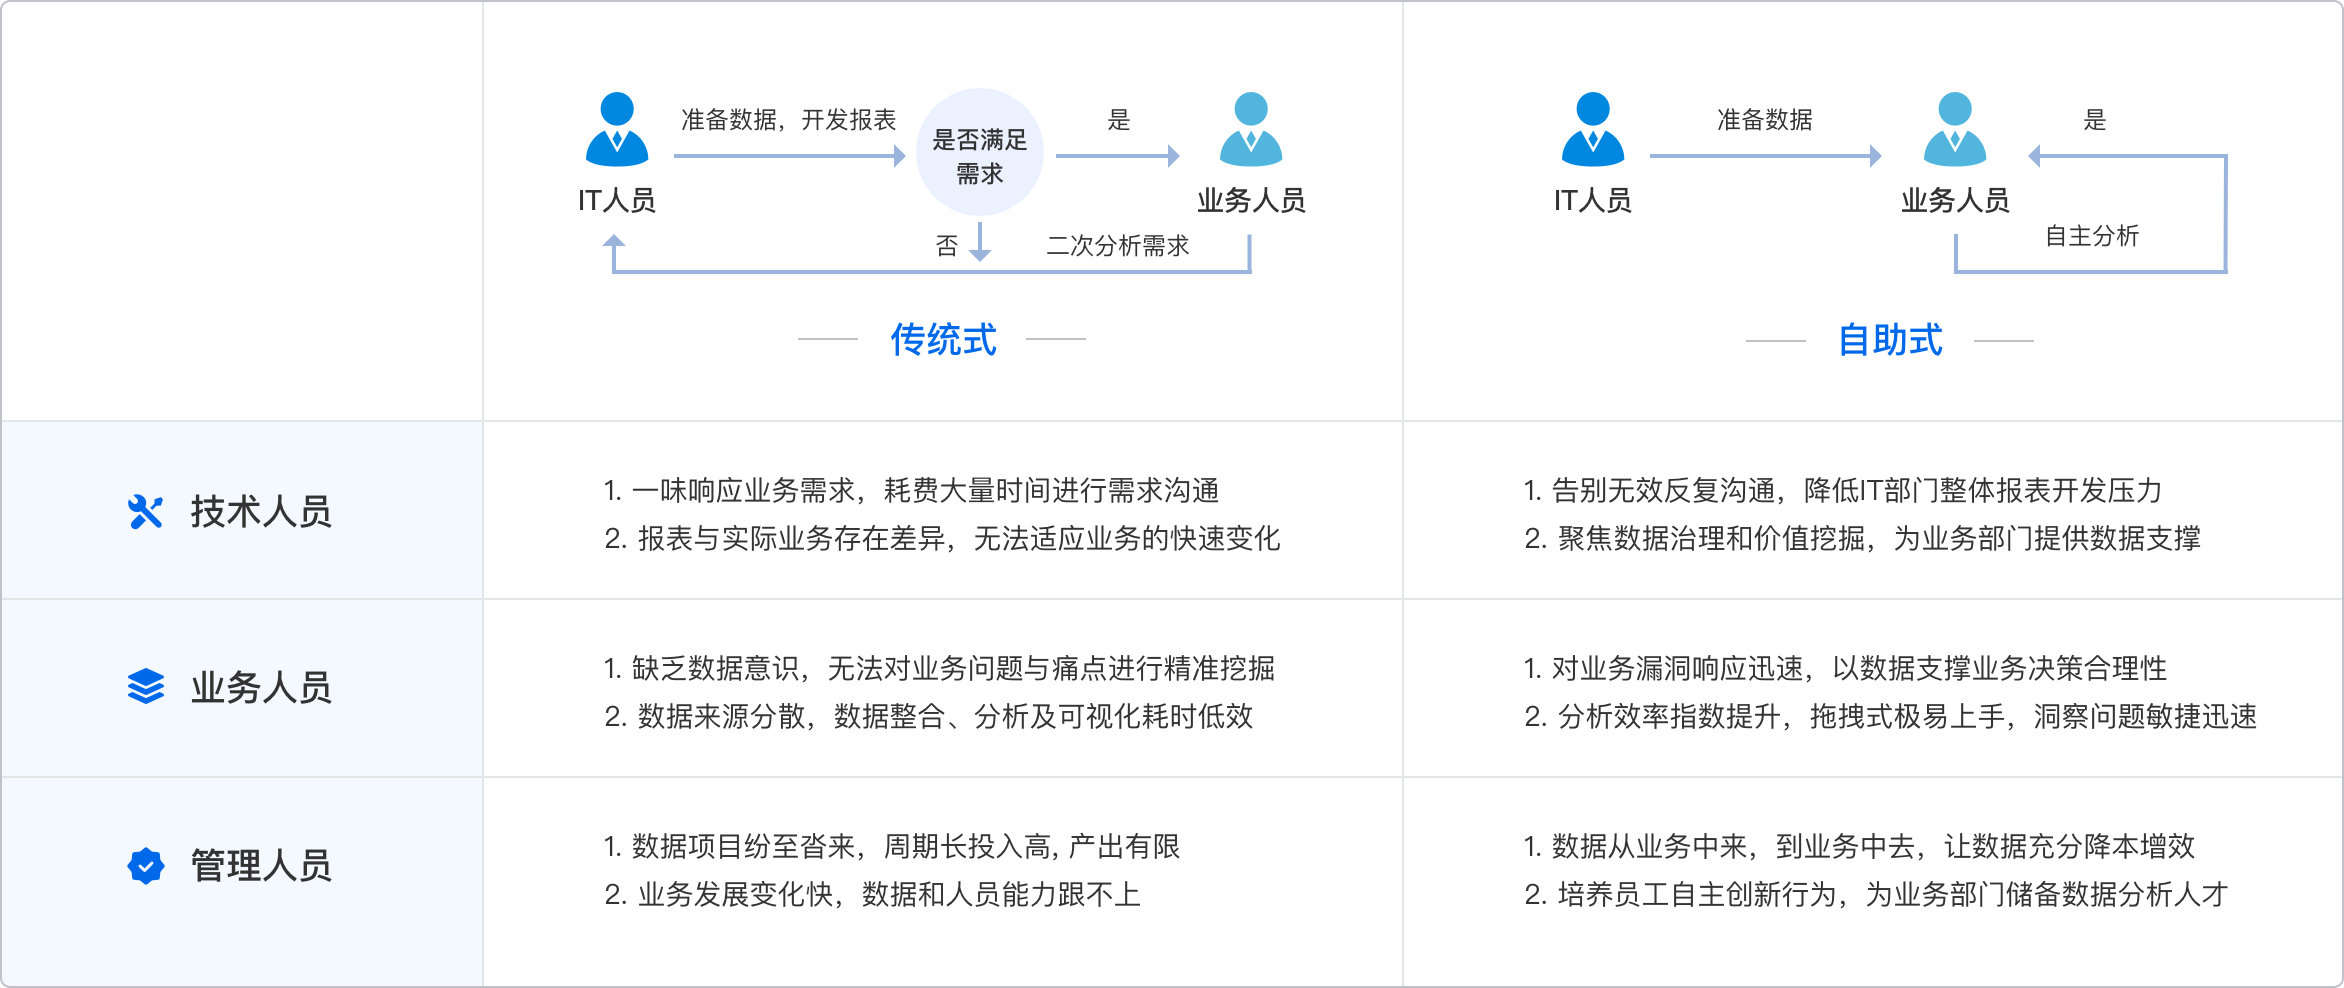
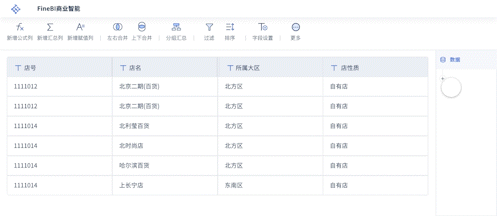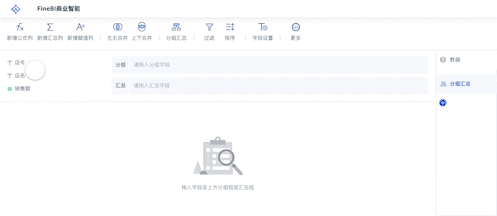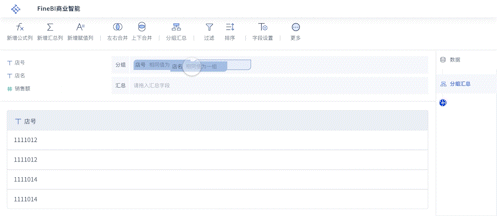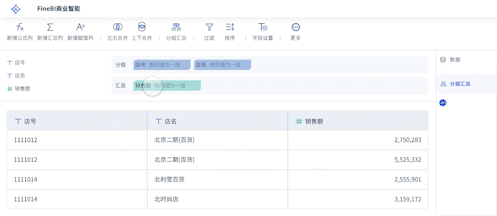
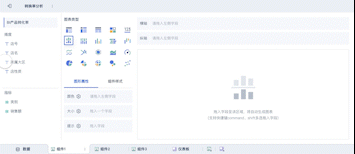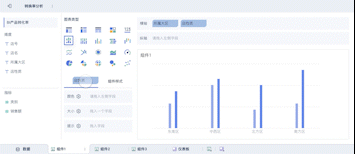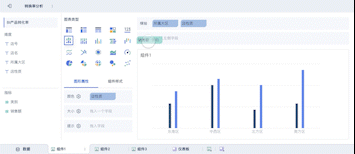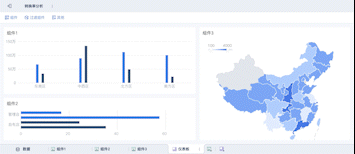
FineBI作为一款强大的商业智能工具,也可以用于手术后重复测量数据分析。FineBI提供了丰富的数据处理和分析功能,包括数据导入、数据清洗、数据转换、数据可视化等。通过FineBI,可以轻松实现数据的预处理和可视化,帮助分析人员快速发现数据中的规律和趋势。此外,FineBI还支持多种统计分析方法和机器学习算法,可以帮助分析人员进行深入的数据分析和模型构建。使用FineBI,不仅可以提高数据分析的效率,还可以提升数据分析的准确性和可靠性。FineBI官网: https://s.fanruan.com/f459r;
在进行手术后重复测量数据分析时,选择合适的分析方法和工具是关键。通过混合效应模型、重复测量方差分析、线性回归模型、广义估计方程、回归树和随机森林等方法,可以对手术后重复测量数据进行深入分析和解释。同时,通过数据预处理和可视化,可以提高数据分析的质量和效果。而使用FineBI等商业智能工具,可以大大提高数据分析的效率和准确性,帮助分析人员更好地理解和利用数据。
相关问答FAQs:
手术后重复测量数据分析的基本概念是什么?
手术后重复测量数据分析主要涉及对同一组受试者在手术前后或不同时间点的多次测量数据进行统计分析。这类数据通常用于评估手术对患者健康状况的影响,例如疼痛评分、功能恢复、生活质量等。分析时需要考虑数据的相关性和重复性,因此常用的方法包括方差分析(ANOVA)、混合效应模型、重复测量t检验等。这些方法能够有效地处理数据的内在相关性,提供更准确的结果。
在进行分析时,首先需要明确研究的目标,比如评估手术前后的变化幅度,或者比较不同手术方法的效果。此外,数据的收集也至关重要,确保在相同的条件下进行测量,以减少外部变量的干扰。通过适当的统计方法,研究人员可以揭示手术对患者的影响,从而为临床决策提供依据。
在手术后重复测量数据分析中,如何选择合适的统计方法?
选择合适的统计方法是手术后重复测量数据分析的关键步骤。一般来说,选择的方法需基于数据的性质、研究设计以及具体研究目标等多个因素。常用的统计方法包括:
-
重复测量t检验:适用于比较两组相关样本(例如,手术前后的同一组患者)的均值差异。这种方法要求数据符合正态分布,并且方差相等。
-
方差分析(ANOVA):当有三个及以上的时间点或组别时,ANOVA是一个理想的选择。它可以检验不同时间点或组别之间的均值是否存在显著差异。
-
混合效应模型:这种方法适用于复杂的重复测量数据,尤其是当数据存在缺失值或数据结构不均衡时。混合效应模型能够处理固定效应(如手术类型)和随机效应(如个体差异)的影响,使得分析更为灵活。
-
广义估计方程(GEE):GEE适合处理具有相关性的重复测量数据,能够估计总体参数而不需要假设特定的分布。
选用统计方法时,除了考虑数据的特征外,还应考虑样本量和研究设计的复杂性。恰当的选择将确保分析结果的有效性和可靠性。
如何解释手术后重复测量数据分析的结果?
在完成手术后重复测量数据分析后,解释结果是一个重要的环节。解读结果时,应注意以下几个方面:
-
统计显著性:分析结果通常会提供p值,p值小于0.05(或0.01)通常被视为统计显著。这表明手术前后或不同组别之间存在显著差异。
-
效应大小:除了p值,效应大小也是衡量结果重要性的一项指标。效应大小可以提供手术对患者影响的实际意义。例如,Cohen's d值可以衡量均值差异的大小,提供更深入的理解。
-
置信区间:置信区间提供了估计值的不确定性范围,能够帮助研究者了解效果的稳定性和可靠性。狭窄的置信区间通常意味着更高的估计精度。
-
临床意义:尽管统计显著性和效应大小提供了数据分析的量化结果,临床意义则是评估这些结果对患者实际生活和健康的影响。研究者需结合临床经验和专业知识进行综合判断。
-
图示展示:使用图表(如折线图、箱线图等)可以更直观地展示数据变化和组间差异,使结果更容易被理解和传播。
通过全面解释分析结果,研究者能够为临床实践提供有效的指导,帮助改善患者的治疗方案和生活质量。
本文内容通过AI工具匹配关键字智能整合而成,仅供参考,帆软不对内容的真实、准确或完整作任何形式的承诺。具体产品功能请以帆软官方帮助文档为准,或联系您的对接销售进行咨询。如有其他问题,您可以通过联系blog@fanruan.com进行反馈,帆软收到您的反馈后将及时答复和处理。