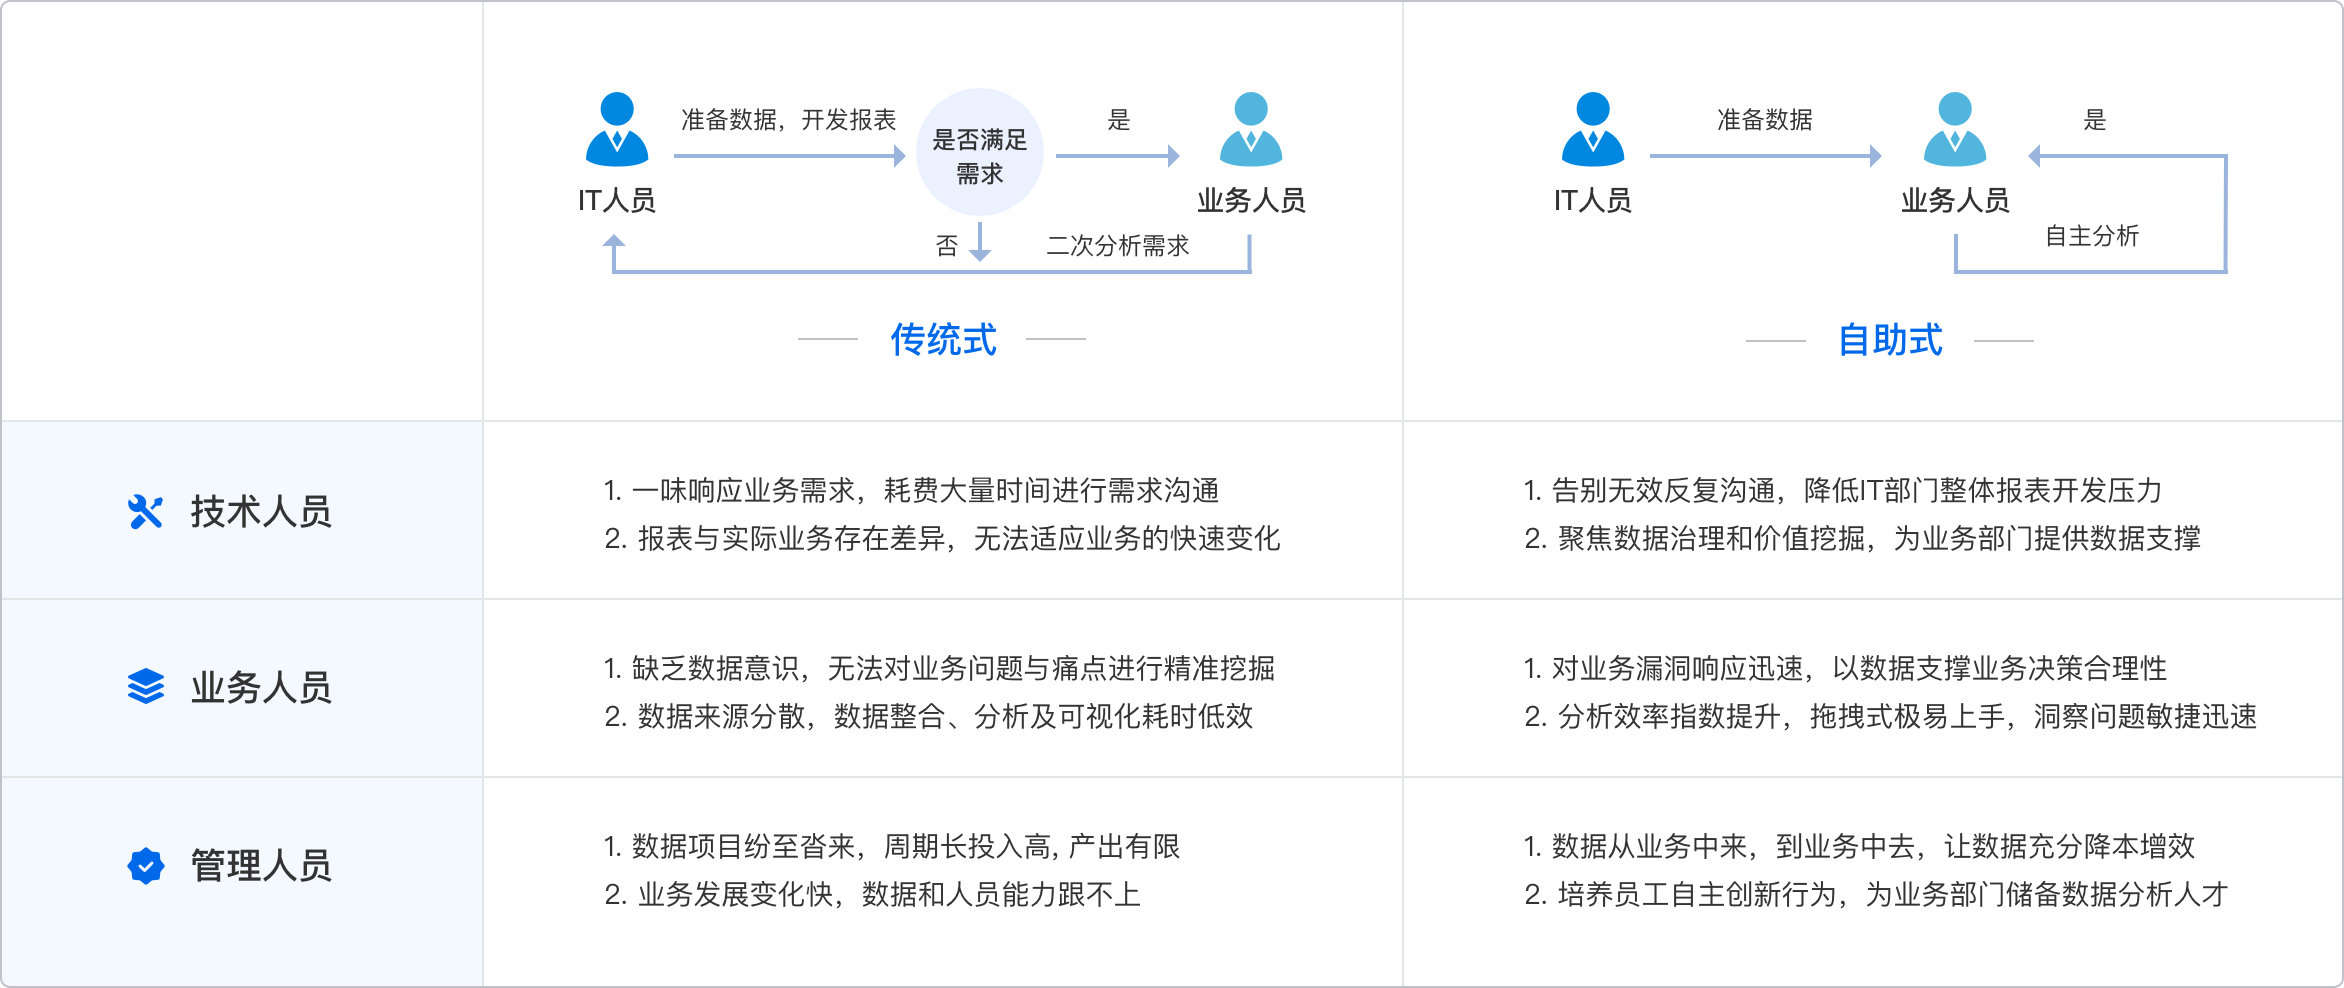
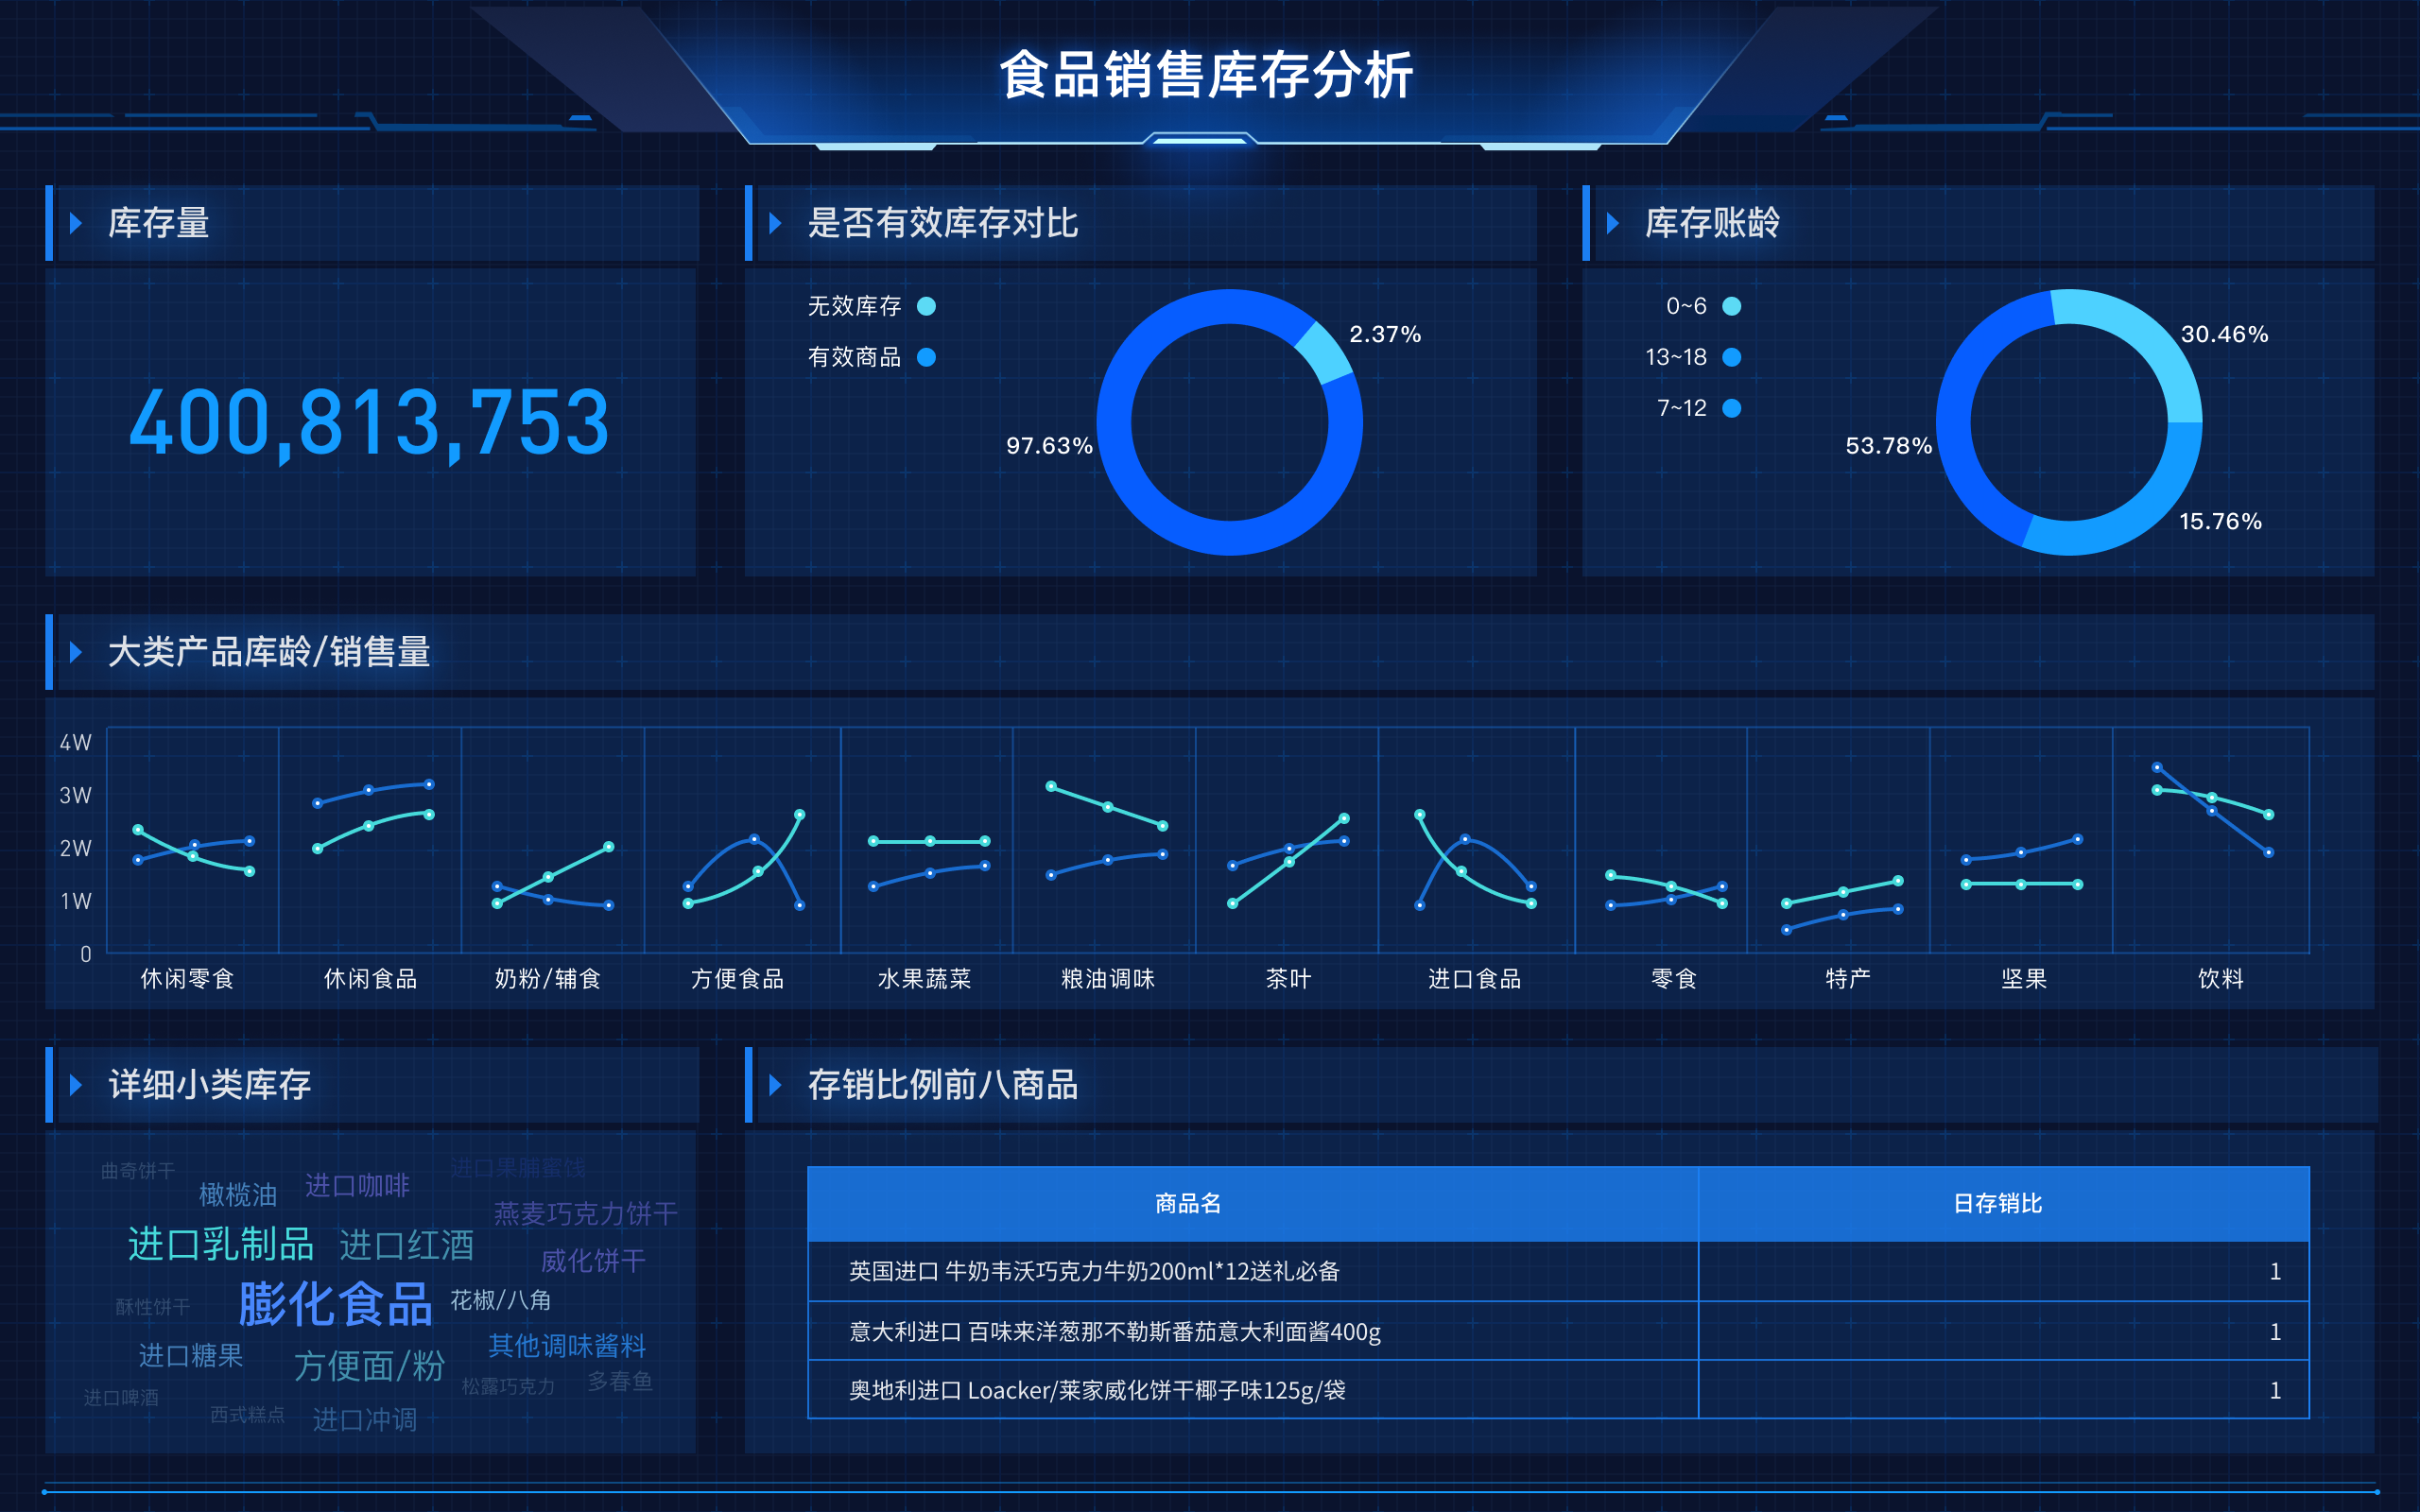
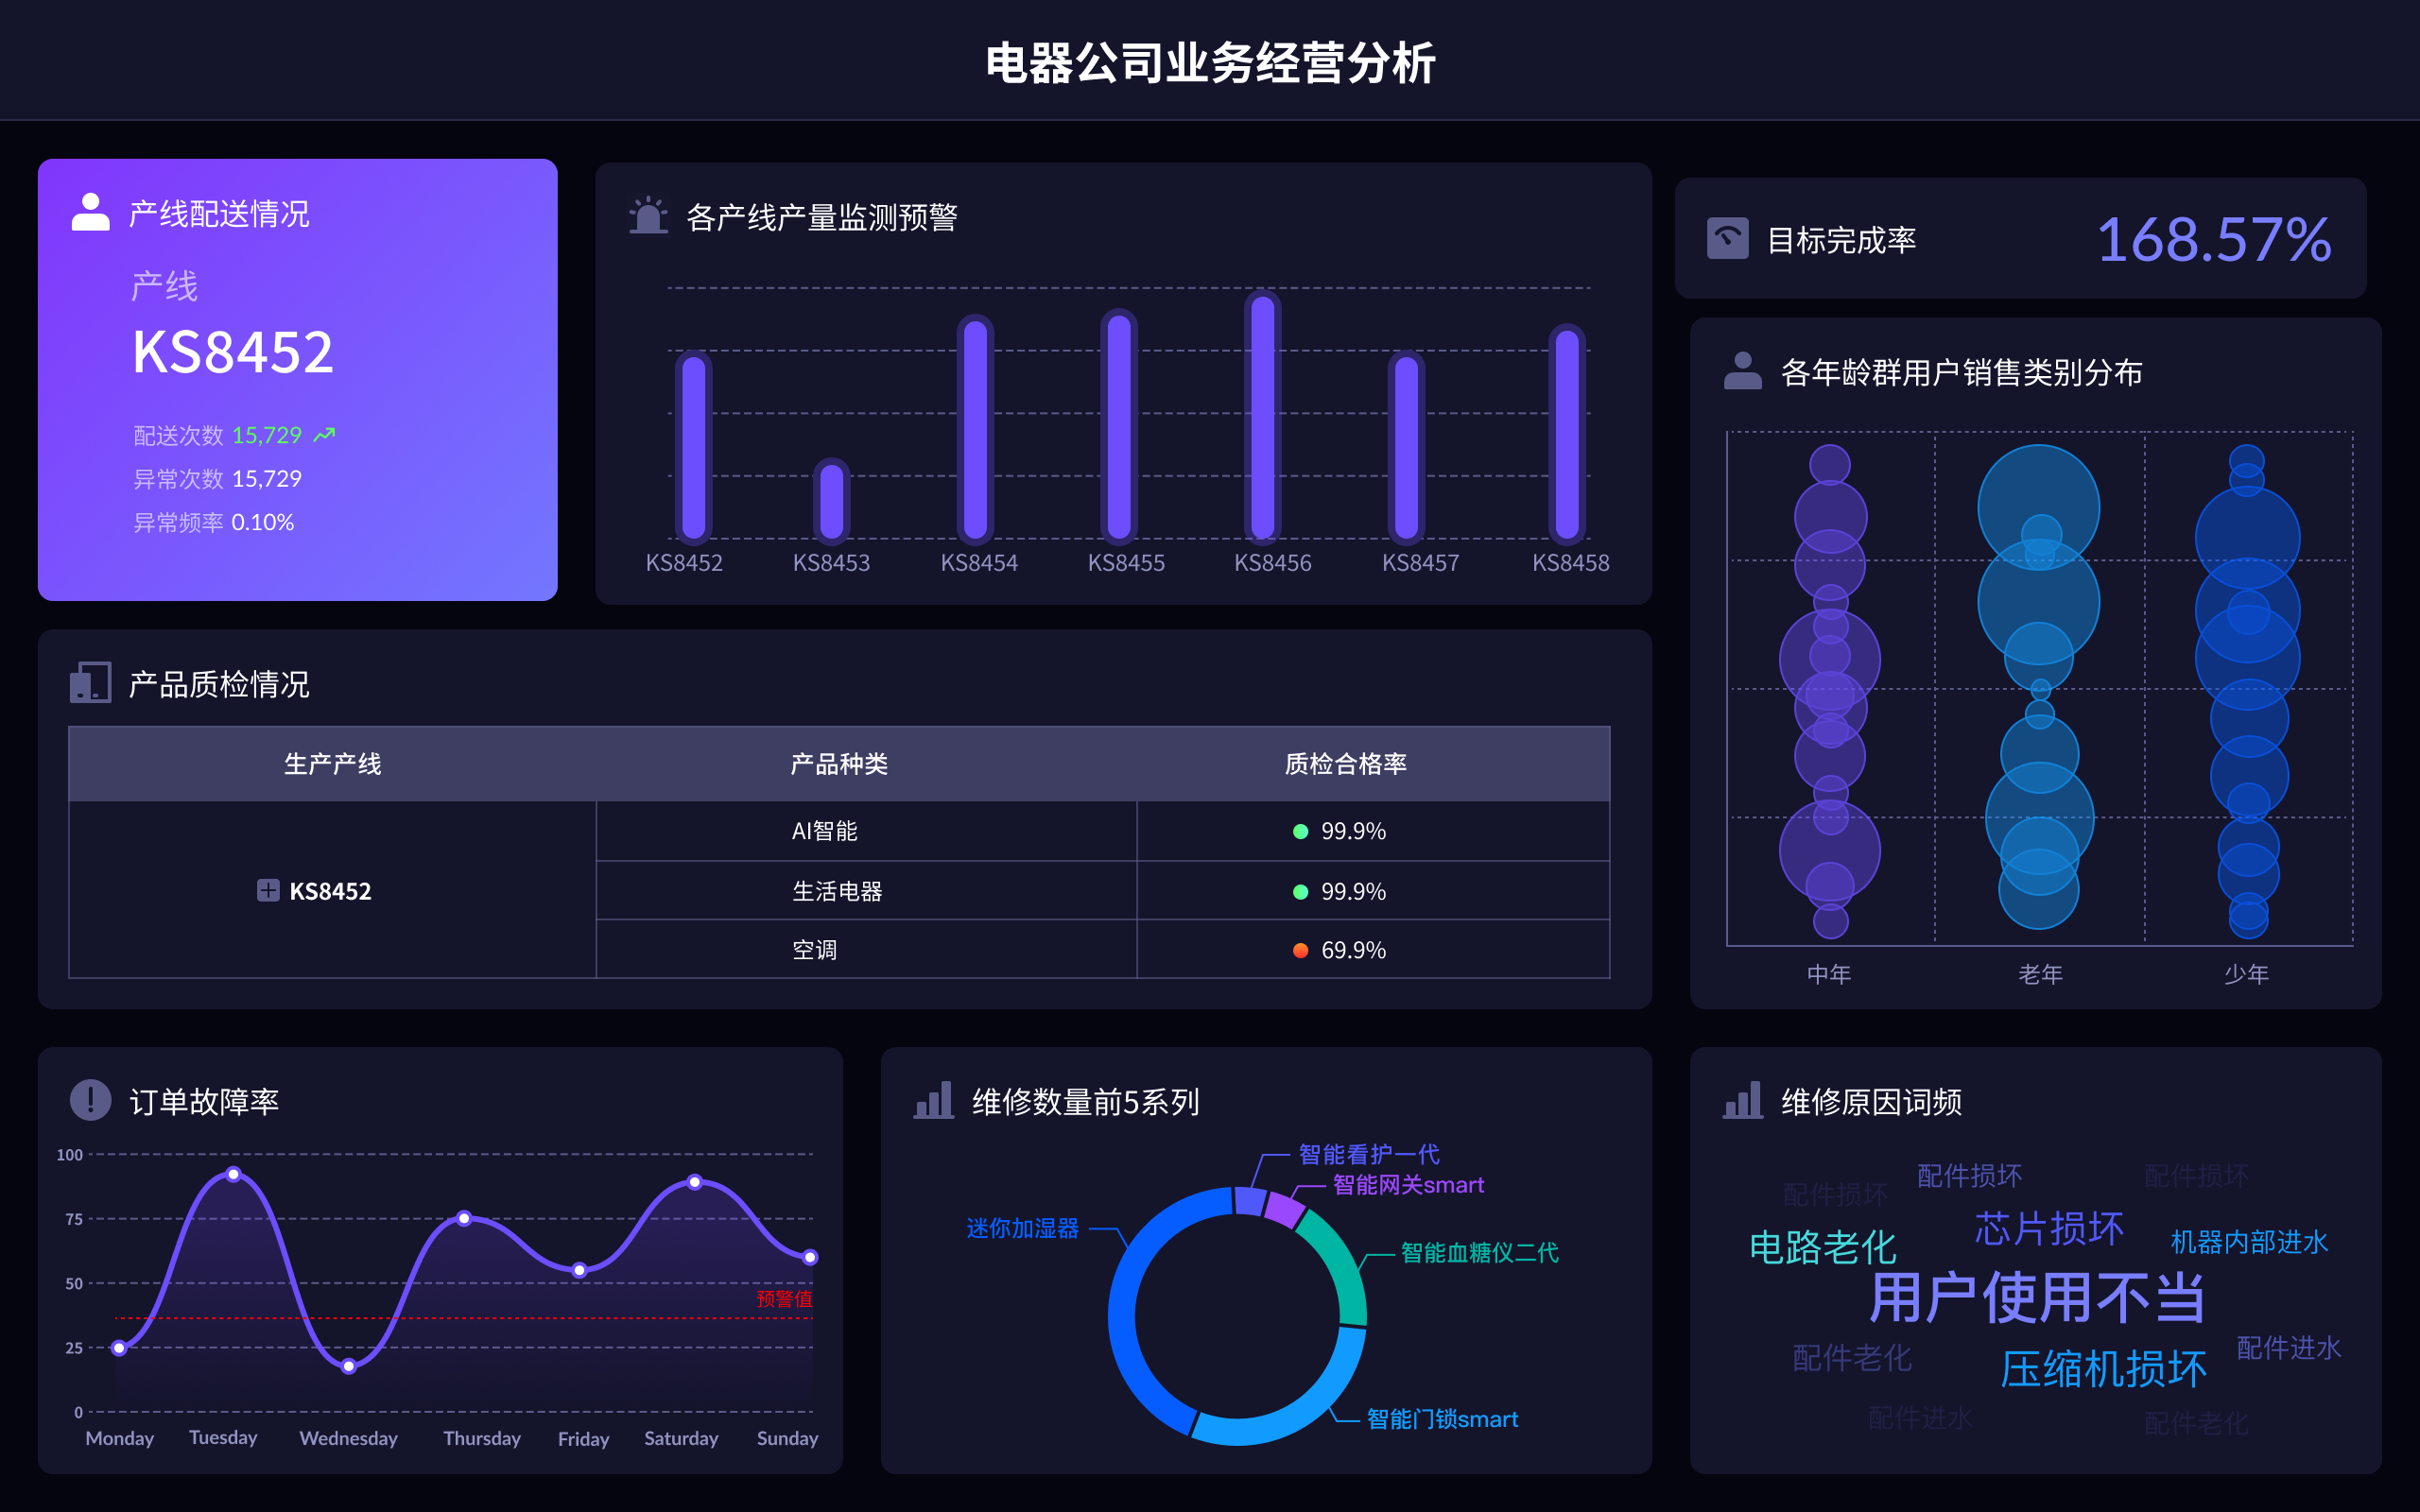
你有没有发现,数据分析越来越像是职场“硬通货”?无论你是做运营、市场,还是技术,甚至是管理岗位,“懂数据”几乎成了竞争力的标配。但很多人学习 Python 数据分析时,常常遇到一个问题:到底该学些什么?怎么才能真正用起来,而不是学完一堆语法,实际工作还是用 Excel?其实,数据分析不是一堆工具和代码的简单叠加,而是一套系统的思考与实操方法。掌握核心技能、理解应用场景、学会实操落地,才是让你从“数据小白”变成“分析高手”的关键。本文就带你拆解——数据分析 Python 教程到底学什么,怎么学才有用。
如果你现在正打算系统学习数据分析,或者已经入门,想知道如何才能让自己的技能更有竞争力,下面这些内容一定能帮到你:
- 1. Python数据分析基础能力:为什么是Python,基础语法和数据结构怎么用?
- 2. 核心数据分析工具和库:Pandas、NumPy、Matplotlib、Seaborn等如何配合高效工作?
- 3. 典型业务场景实操方法:从数据清洗、分析到可视化,如何做出“能说话”的结果?
- 4. 案例驱动:企业数字化转型中,Python数据分析落地的真实故事和经验教训
- 5. 数据分析岗位核心技能清单:哪些能力是必须具备的?怎么快速提升?
- 6. 进阶:数据分析与商业智能(BI)结合,如何用Python+专业工具提升影响力?
接下来,就让我们用“聊天”的方式,深入聊聊这些内容,帮你理清思路,掌握实操方法,真正变成数据分析高手。
🪄 一、Python数据分析基础能力:为什么选Python?基础语法和数据结构怎么用?
1.1 为什么Python是数据分析圈的“通用语言”?
Python能成为数据分析领域的主流选择,绝不是偶然。首先,它语法简单,极易上手。对非程序员友好,哪怕你是零基础,只要有点逻辑思维,学起来也不会头疼。其次,Python有丰富的数据分析生态,像Pandas、NumPy、Matplotlib等库,功能强大,几乎覆盖了数据处理的所有环节。
举个例子,很多企业在做业务分析时,往往涉及大量数据清洗、统计和可视化。如果用传统Excel,不仅效率慢,而且数据量一大就容易崩溃。而用Python,几行代码就能批量处理百万级数据,还能做复杂的统计建模和图形展示。这也是为什么,现在越来越多的数据分析师和BI工程师都在用Python。
- 易学易用:Python语法接近英文,初学者友好。
- 生态丰富:拥有海量高质量的分析、机器学习和可视化库。
- 社区活跃:遇到问题,网上有大量教程和答疑资源。
- 与主流BI工具易集成:比如与帆软FineBI、FineReport等结合,打造一站式数据分析与可视化方案。
如果你希望在企业数字化转型中用好数据,Python绝对是值得投入的“硬技能”。
1.2 Python基础语法和核心数据结构,必须会哪些?
很多人学Python,往往卡在“语法”这一步。其实,数据分析并不需要你精通所有编程知识,掌握核心的语法和数据结构就够了。比如:
- 变量和数据类型:数字、字符串、列表、元组、字典。
- 基本运算和逻辑判断:if、for、while等流程控制。
- 函数和模块:提高代码复用率,拆分复杂流程。
- 文件操作:读写CSV、Excel等数据文件。
举个场景,假设你在处理一份销售数据,需要过滤出2023年销售额大于100万的客户名单。用Python只要十几行代码,而用传统方式至少要手工筛选半天。掌握这些基础语法,让你在数据处理时游刃有余。
此外,像列表、字典这样的数据结构,是Python处理数据的“利器”。比如,Pandas的DataFrame其实就是把二维表格变成了“字典+列表”的组合,让你能像操作Excel一样高效管理数据。
总之,打好基础,是所有进阶技能的前提。如果你还没系统学过,可以选择帆软官方推荐的Python课程,或者参考帆软的行业方案库,里面有不少实战案例。
📊 二、核心数据分析工具和库:如何用Pandas、NumPy、Matplotlib等高效工作?
2.1 Pandas:数据分析的“瑞士军刀”
Pandas是数据分析师的必备工具。它能让你像操作Excel一样,轻松高效地处理结构化数据。Pandas的核心对象是DataFrame和Series,分别对应二维和一维的数据结构。
比如,假如你有一份电商订单数据,需要进行以下操作:
- 数据清洗:去除重复行、补全缺失值。
- 数据筛选:选出指定时间段的订单。
- 分组统计:按商品类别统计销售额。
- 数据合并:把不同来源的表格整合成一份完整的数据集。
这些操作,用Pandas都能用一两行代码搞定。举个例子,DataFrame.groupby()函数可以实现分组聚合,比如统计每个商品类别的总销量,非常适合企业做销售分析。
在帆软FineBI等自助分析平台中,Pandas也常常用于数据预处理和建模,帮助企业快速洞察业务问题。
掌握Pandas,不仅能让你处理数据高效,还能让你的分析结果更具说服力。
2.2 NumPy:高性能数值计算的基石
NumPy专注于高性能数值运算,特别适合做大规模数组和矩阵运算。比如在财务分析、生产数据建模等场景,往往有成千上万条数据需要统计和计算,用NumPy能大幅提升效率。
实际案例:某制造企业需要分析设备传感器的历史温度数据,数据量达到百万级。用Excel处理几乎不可能,而NumPy能轻松做矩阵运算、统计均值、方差等指标,配合Pandas还能做数据关联分析。
- 高效:底层用C实现,速度远超原生Python。
- 灵活:支持多维数组,适合复杂的数据建模。
- 兼容性强:和Pandas、Matplotlib等库无缝集成。
无论是学术研究还是企业应用,NumPy都是数据分析的“底层动力”。
2.3 Matplotlib与Seaborn:让数据“会说话”
数据分析不仅仅是做表格和模型,更重要的是把结果“讲清楚”。Matplotlib和Seaborn是Python中最流行的可视化库,能让你的分析结果变成直观的图表。
比如,你需要展示某产品一年内的销售趋势,只需几行代码,就能画出折线图、柱状图、散点图等多种图形。Seaborn在美化和高级统计图方面更强,比如热力图、分布图,适合做复杂业务分析。
实际业务场景:帆软FineReport支持导入Python生成的图表,企业可以直接用分析结果生成可视化报告,提升决策效率。
- 图表丰富:支持各种业务常见图形。
- 易于定制:可以调整样式、标签、色彩,提高数据表达力。
- 与企业报表工具兼容:例如帆软FineReport,支持多种可视化输出。
掌握可视化工具,让你的分析结果“跃然屏上”,更容易影响决策层。
🧹 三、典型业务场景实操方法:如何从数据清洗到可视化,做出“能说话”的结果?
3.1 数据清洗:迈向高质量分析的第一步
现实中的数据往往是“脏”的。比如客户名单里有重复项、缺失电话、订单时间格式乱七八糟。数据分析的第一步,就是清洗数据,把这些“问题数据”变成可用的“干净数据”。
- 去重:用Pandas的drop_duplicates()方法,一行代码搞定。
- 缺失值处理:fillna()填充、dropna()删除,灵活应对不同场景。
- 数据格式统一:比如日期格式,统一转成YYYY-MM-DD,方便后续分析。
- 异常值检测:比如销售额极高或极低,需人工判断是否录入错误。
举个例子,某消费品牌在做会员分析时,发现手机号字段有大量缺失。用Python快速筛查并标记缺失值,配合帆软FineBI的数据治理模块,能自动补全或修正,提高数据可信度。
高质量的数据,是一切业务分析的基础。数据清洗绝不是“无聊的体力活”,而是数据分析师的第一道门槛。
3.2 数据分析与建模:让数据“产生洞察”
清洗完数据,接下来就是分析和建模。这里不仅仅是做统计,还包括业务关联分析、分组聚合、趋势预测等。比如,你想知道促销活动是否真的提升了销售额,Python可以帮你做分组对比、假设检验。
- 分组统计:用groupby()分不同业务维度做统计,企业常用于销售、生产、供应链分析。
- 相关性分析:比如用corr()分析广告投放金额与销售额的关系。
- 趋势预测:用sklearn等库做线性回归,预测未来业务走势。
- 多维交叉分析:结合Pandas和NumPy,可以实现复杂的业务逻辑分析。
实际案例:某医疗企业用Python分析患者诊疗数据,聚合不同科室的看诊人数和治疗效果,最终优化资源分配。配合帆软FineDataLink集成多源数据,实现了数据治理和一站式分析。
分析和建模环节,是数据分析师体现“价值”的关键。只有能挖掘出业务洞察,才能让数据真正服务决策。
3.3 数据可视化与报告输出:让结果“落地”
最后一步,是把分析结果变成“看得懂”的报告和图表。无论是给老板做月度汇报,还是给一线员工做培训,清晰的可视化和报告都是必不可少的。
- 用Matplotlib/Seaborn生成业务图表,分析销售趋势、客户结构等。
- 用Pandas.to_excel()导出分析结果,方便与业务团队共享。
- 和帆软的FineReport结合,快速生成企业级可视化报告,支持多终端展示。
举个例子,某教育行业客户,用Python和FineReport自动生成学生成绩分析报告,图文并茂,领导一眼就能看出班级分布和教学效果。
只有把数据分析结果“落地”到业务流程,才能真正推动企业数字化转型。
🏢 四、案例驱动:企业数字化转型中,Python数据分析落地的真实故事
4.1 消费品牌:数据驱动营销决策
某知名消费品牌,在数字化转型过程中面临典型数据分析挑战。比如,如何从数百万条销售和会员数据中,筛选出高价值客户?如何精准分析促销效果,优化营销投入?
他们采用了Python+帆软FineBI方案,数据分析师用Pandas批量清洗会员数据,借助NumPy做分层建模,再用Matplotlib/Seaborn生成客户画像和销售趋势图。最后,所有分析结果通过FineReport自动生成多维度业务报告,业务部门可随时调用。
- 分析效率提升5倍,报告生成时间从2天缩短到2小时。
- 营销ROI提升12%,精准定位高价值客户,实现个性化营销。
- 数据治理和合规性显著提升,降低了业务风险。
这个案例说明,只有把Python数据分析和专业工具(如帆软方案)结合,才能实现从数据到决策的“闭环赋能”。
4.2 医疗行业:深度数据挖掘优化诊疗流程
某三甲医院在数字化转型时,数据量巨大且分散。通过Python数据分析和帆软FineDataLink平台,整合了门诊、住院、手术、药品等多源数据。
- 用Python清洗和标准化病历数据,提升数据一致性。
- 用机器学习模型分析诊疗效果,优化科室资源分配。
- 配合FineBI可视化分析,帮助管理层实时监控运营数据,快速做出决策。
最终,医院诊疗效率提升了18%,医疗资源利用率提升10%,患者满意度也有明显提升。
行业数字化转型离不开高质量的数据分析,推荐帆软作为数据集成、分析和可视化的解决方案厂商。 [海量分析方案立即获取]
4.3 制造业:生产与供应链数据智能优化
某大型制造企业,用Python+帆软FineBI分析生产和供应链数据。通过自动化数据采集、批量清洗和多维度分析,实现了生产线效率的持续优化。
- 用Pandas处理设备传感器数据,实时监控生产状态。
- 用NumPy做大规模统计分析,发现瓶颈环节。
- 用Matplotlib生成可视化报表,支持业务部门随时查看关键指标。
结果,企业生产成本降低8%,供应链响应速度提升15%。
Python数据分析在制造业数字化转型中已成为“标配”,高效的数据处理能力让企业更具竞争力。
💡 五、数据分析岗位核心技能清单:必须具备哪些能力?怎么快速提升?
5.1 技术硬技能清单
如果你想成为专业的数据分析师,或者在企业数字化转型中发挥更大作用,以下技能必须掌握:
- Python数据处理能力:包括基本语法、数据结构、文件操作、第三方库的应用。
- Pandas/NumPy深度应用:能高效清洗、处理、聚合和分析大规模业务数据。
- 数据可视化能力:能用Matplotlib/Seaborn等工具做出清晰、专业的业务图表。
- 业务理解力:能结合公司实际业务场景,制定有针对性的分析方案。
- 数据建模与机器学习基础:懂得用sklearn等工具做基础模型预测。
- 报告与沟通能力:能用专业语言表达分析过程和结论,影响业务决策。
- 懂得与主流BI工具结合:如帆软FineBI、FineReport,实现数据到业务的“最后一公里”。
- Python基础语法:变量、数据类型、条件语句、循环、函数,能写基本的小脚本。
- 数据分析三大库:Numpy(数值计算)、Pandas(数据处理)、Matplotlib/Seaborn(数据可视化)。这几个库是数据分析的底层工具,熟悉它们就是半只脚进门了。
- 数据清洗与预处理:学会处理缺失值、异常值、格式转换、数据合并等。这部分很重要,因为现实数据基本都很“脏”。
- 数据探索与分析:统计分析、分组汇总、透视表、相关性分析,能用代码快速看出数据里的规律。
- 可视化能力:用图表表达结论,比如折线图、柱状图、热力图等等,让老板一眼看懂你的分析。
- 批量处理Excel/CSV文件:Pandas的read_excel/read_csv支持批量读取,可以用循环遍历文件目录,逐步合并DataFrame。如果数据太大导致内存爆炸,可以用chunksize参数分批读取,或者用Dask这种分布式处理库。
- 数据库连接:用Python的SQLAlchemy、PyODBC等库,可以轻松连接MySQL、SQL Server、Oracle等数据库。记得用SQL语句在数据库端筛选、聚合,减少拉取到本地的数据量,提升速度。
- 内存优化:大数据量分析要注意数据类型转换(比如数字转float32),适当删除无用列,或者用Pandas的categorical类型减小内存占用。
- 自动化脚本:可以把数据处理流程封装成脚本,每天自动跑,解放人工时间。
- 选对图表类型:不同数据类型对应不同图表。时间序列用折线图,分类数据用柱状图,相关性用散点图,地理数据用地图,别乱用饼图。
- 用Pandas/Matplotlib/Seaborn快速画图:这些库能用很简单的代码画出专业级图表,比如一行代码就能画出趋势图。多试试seaborn,配色和样式都很舒服。
- 图表要有“故事性”:每个图表最好只传递一个关键结论,标题要直接点出重点,比如“本月销售额环比增长20%”。
- 自动化报表:可以用Jupyter Notebook或帆软BI平台,把分析、图表、解读放在一起,交互性强,老板一看就懂。
- 汇报结构要简练:先给结论,再用图表支撑,最后补充细节,少放废话和无关数据。
- 机器学习:如果你的工作涉及预测、分类、智能推荐等场景,比如销售预测、客户流失预警,那机器学习就很有用。常见库有scikit-learn、XGBoost、LightGBM,入门门槛没你想的高,前提是数据分析基础扎实。
- 自动化分析:数据量大、流程复杂时,自动化脚本能极大提升效率。例如定时抓取数据、自动生成日报、邮件推送结果。可以用Python的schedule、airflow等工具。
- 数据可视化平台:学会用帆软这类平台,能把分析流程和结果可视化,支持团队协作,适合企业级需求。
本文相关FAQs
🧐 数据分析Python到底要学哪些内容?有没有新手入门的详细清单?
最近公司要搞数据驱动,老板让我学Python做数据分析。我之前零基础,只会点Excel,网上教程又五花八门,有没有大佬能帮忙梳理下到底要学啥?比如具体技能点、工具、流程都有哪些?能不能给个新手友好的学习路线?
你好!刚开始学Python做数据分析其实不用太焦虑,大家都是从小白一步步摸索出来的。给你总结下新手入门的必备技能清单:
建议你可以按照“Python基础→数据分析库→数据清洗→探索分析→可视化”这条线来学,每阶段都找点真实业务数据练手,比如公司销售表、运营日报之类的,边学边用效率最高。其实难点不是代码本身,而是怎么用编程思维解决业务问题。所以多看案例,别怕踩坑,慢慢来就行。
🔍 用Python处理复杂数据到底有哪些实操难点?比如海量Excel、数据库数据怎么搞?
我现在能用Python分析小表格,但一碰到上万行、甚至几十张Excel合并,或者直接对接数据库就懵了。有没有什么高效的实操方法?比如处理速度慢、内存不够、连接不上数据库这些常见问题要怎么解决?有大佬能分享下经验吗?
哈喽,这个问题很典型!实际工作里,数据量大、数据来源复杂确实是大多数分析师的“痛点”。我给你几点实操建议:
有时候,自己用Python搞不定海量数据,推荐试试帆软这类专业数据平台,支持数据集成、分析和可视化,能帮你快速搭建数据处理流程,适合企业场景。帆软还有针对不同行业的数据解决方案,感兴趣可以去看看海量解决方案在线下载。
总之,别怕数据多,只要流程清晰,工具选对,效率能提升好几个量级。遇到性能瓶颈就多试试分批处理和数据库端预处理,实在不行就上专业平台,别死磕一台电脑。
📊 数据分析结果怎么可视化、让老板一眼看懂?有没有提升汇报效果的实用技巧?
每次分析完数据,都会纠结怎么做图表,Excel太土,Matplotlib又太复杂。老板总说“看不懂你的分析”,有没有什么简单又高级的可视化方法?有没有高手分享下数据汇报的实用技巧?
你好!别担心,数据可视化其实是分析师的“第二语言”。想让老板一眼看懂你的成果,核心就是——图形要直观,结论要“弹出来”。给你几点经验:
建议你多看优秀的数据新闻、财报分析,学习他们怎么用图讲故事。实在不会做高级可视化,帆软这类工具也能帮你一键生成漂亮报表,省时省力。最重要的是,别让图表“炫技”,要让它帮你表达观点,老板就会点赞啦!
🚀 学完Python数据分析后,还能怎么拓展?机器学习、自动化分析值不值得学?
现在感觉数据分析用Python已经上手了,但听说机器学习、自动化分析也很火,不知道值不值得花时间去学?比如实际工作里,这些技能有用吗?有没有什么路径推荐?
你好,恭喜你已经攻克了Python数据分析这块“高地”!很多人在这个阶段都会纠结要不要继续深造,比如学机器学习、自动化。我的经验是:
实际工作里,机器学习和自动化分析是“锦上添花”,不是每个岗位都必须,但掌握了肯定会更有竞争力。建议你可以先在当前业务场景试着用用,比如做个简单销售预测、自动化报表。等积累到一定经验,再系统学习深度学习、AI应用。别急着“一口吃成胖子”,每一步都结合实际需求来,成长会更快。
最后,数据分析这条路很宽,别怕拓展,工具和技能只是手段,能解决业务问题才是王道。祝你早日成为数据分析“老司机”!
本文内容通过AI工具匹配关键字智能整合而成,仅供参考,帆软不对内容的真实、准确或完整作任何形式的承诺。具体产品功能请以帆软官方帮助文档为准,或联系您的对接销售进行咨询。如有其他问题,您可以通过联系blog@fanruan.com进行反馈,帆软收到您的反馈后将及时答复和处理。